本文译自 rari(@0xwhrrari)的长文《Jev Engineering: Stop Using LLMs for Every Decision》,原文链接在此(完整出处与版权声明见文末)。代码块、字段名、命令与 JSON 保持原文不译。
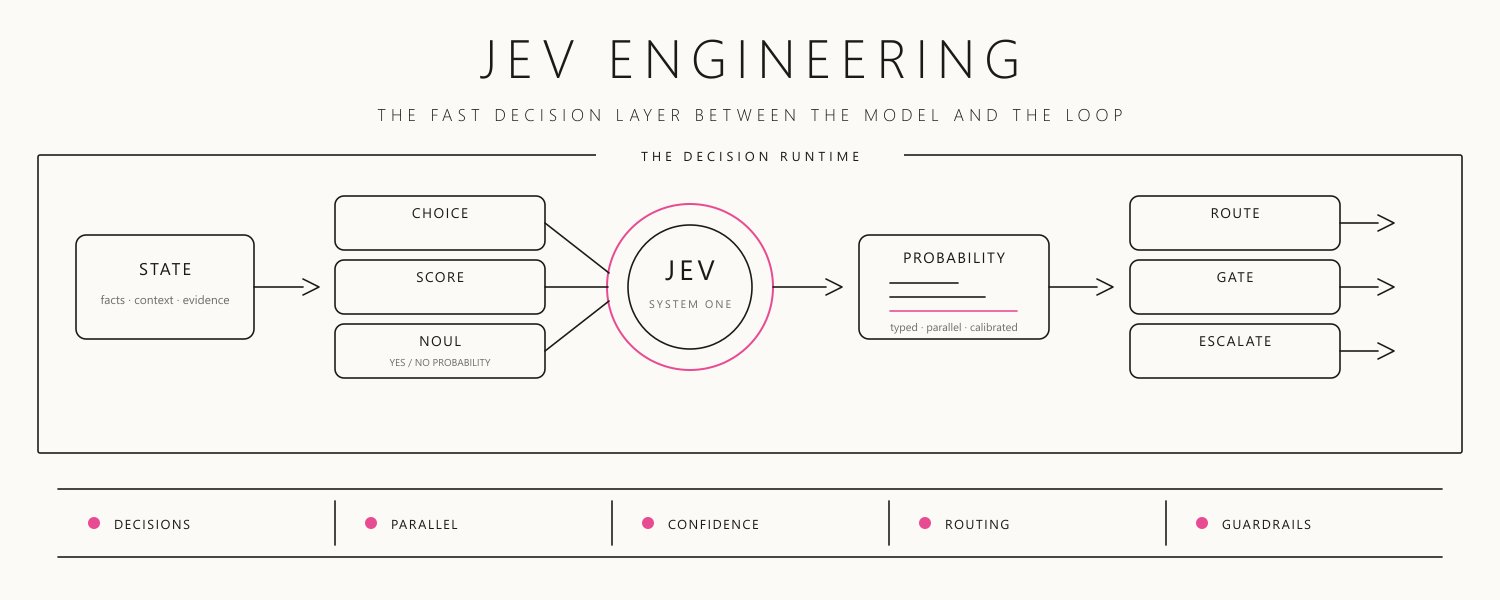
图:原文头图(作者自制英文信息图,原样保留)。
那条让 AI Agent 更便宜、更快、也更好控制的快速判断层。
大多数 AI Agent 都建立在一个昂贵的假设之上:
每一个智能判断,都要再来一次 LLM 调用。
下一步该由哪个 worker 执行?这条来源相关吗?这个结果可以直接发布吗?任务看起来完成了吗?系统应该重试、升级,还是停下来?
这些判断,没有一个需要写成一段话。
可大多数 Agent 技术栈仍然让一个生成式模型用散文推理、吐出 JSON、等解析器、然后祈祷 schema 别崩。
这不是智能架构。
这是把聊天机器人当 switch 语句在用。
Jev 换掉了这个原语。
它不生成文本。
它读取系统的当前状态,评估带类型的问题,返回软件可以直接据以行动的概率。
收益不是白来的:Jev 不能生成文本。
—— Diogo Almeida,TypeSafe AI 创始人
这个限制恰恰就是重点。
当一个模型放弃开放式字符串,它就能成为代码内部更快、更可组合的判断层。
这次发布里真正重要的,不是又多了一个模型。
而是 Agent 内部出现了新的分工:
LLM   创造工作
JEV   决定接下来发生什么
CODE  执行并强制执行这个决定
本文要讲的,就是如何把这个分工工程化地拆对。
我在 Substack 上持续发布关于 AI Agent、工作流与生产系统的实操拆解。点这里订阅通讯。
原文在此处嵌入了一条推文(@CompleteSkeptic,2026-09-15 18:17 UTC,即 Jev 发布当天):[1]
在共同发明 ChatGPT 之后,我一直在问自己:为什么超人类的聊天模型并没有带来 AGI?
过去两年我一直在隐身开发一种新的模型训练方式(RLCD),以及一类新的前沿 AI 模型,今天我们正式发布:Jev
• 快 20–200 倍 • 便宜 40–400 倍(输出 token 免费) • 为决策优化的、前沿的、可组合的智能
据我所知,这是通往「AI 驱动的经济革命」最短的那条路。
—— 原文推文
大多数 Agent 里那个昂贵的错误
从外面看,Agent 循环很简单:
goal -> model -> tool -> observation -> model -> tool -> result
但放大一看,你会发现在那些大动作之间,藏着几十个小判断:
Is the request clear enough
Which tool should run
Which model should receive this task
Which source should survive retrieval
Is the tool call risky
Did the action actually work
Is the evidence strong enough to stop
通常的做法是:把每一个问题都送回同一个前沿 LLM。
这带来四个问题。
延迟会复利式叠加
多一次模型调用,感觉不贵。
二十次串行调用就贵了。
一个 Agent 花在「要不要继续」上的时间,可能比它真正干活的时间还长。
成本转移到看不见的分支里
最终答案可能很短。
但内部的路由、打分、检查、重试判断,可能吃掉大部分 token 预算。
字符串带来集成工作量
模型返回散文或者 JSON。
你的代码去校验它、修补它、重试它,或者悄悄接受一个畸形的边界情况。
置信度是临时编出来的
LLM 可以说自己有 95% 的把握。
那个数字通常只是又一个生成的 token,而不是一个经过校准的运行信号。
更深一层的问题是架构性的:
生成与决策,被压缩进了同一次调用。
Jev 工程的第一步,就是把它们分开。
Jev 不是缩小版的聊天机器人
TypeSafe 称 Jev 是它的第一个 System One Model。
它的接口更接近一个前沿智能函数,而不是一场对话:
INPUT
current state + typed questions

OUTPUT
typed answers + probability distributions
Jev 不写邮件草稿。
但它能判断这封邮件该进哪个队列。
它不写研究报告。
但它能打分:收集到的证据是否充分。
它不执行 shell 命令。
但它能估计:这条待执行的命令是否需要审批。
它不会用一长串思维链来解释自己。
它返回一个受限的答案,而你的代码早就知道该怎么处理。
TypeSafe 用一种它称为 RLCD(Reinforcement Learning for Calibrated Decisions,面向校准决策的强化学习)的训练方法构建了这个模型。
目标不是更漂亮的语言。
目标是决策质量,加上有用的不确定性。
TypeSafe 报告称,Jev 形态的查询端到端延迟大约为 70–500ms,定价为每百万输入 token 0.042 美元,且不计输出 token 费用。
它那些更大的速度与成本声称,来自对有利工作流的评估,应当被当作上限,而不是对所有应用场景的承诺。
这个细微差别很重要。
即使 Jev 没有快 200 倍,它依然有价值。
更深的收益在于:一个判断变成了显式的、带类型的、可测试的组件。
原文在此处嵌入了一条推文(@typesafeai,2026-09-15 19:33 UTC):[2]
我们正式走出隐身模式了!加入前沿,在我们的官网获取 Jev 访问权限(链接在个人主页)。
—— 原文推文
三层 Agent 架构
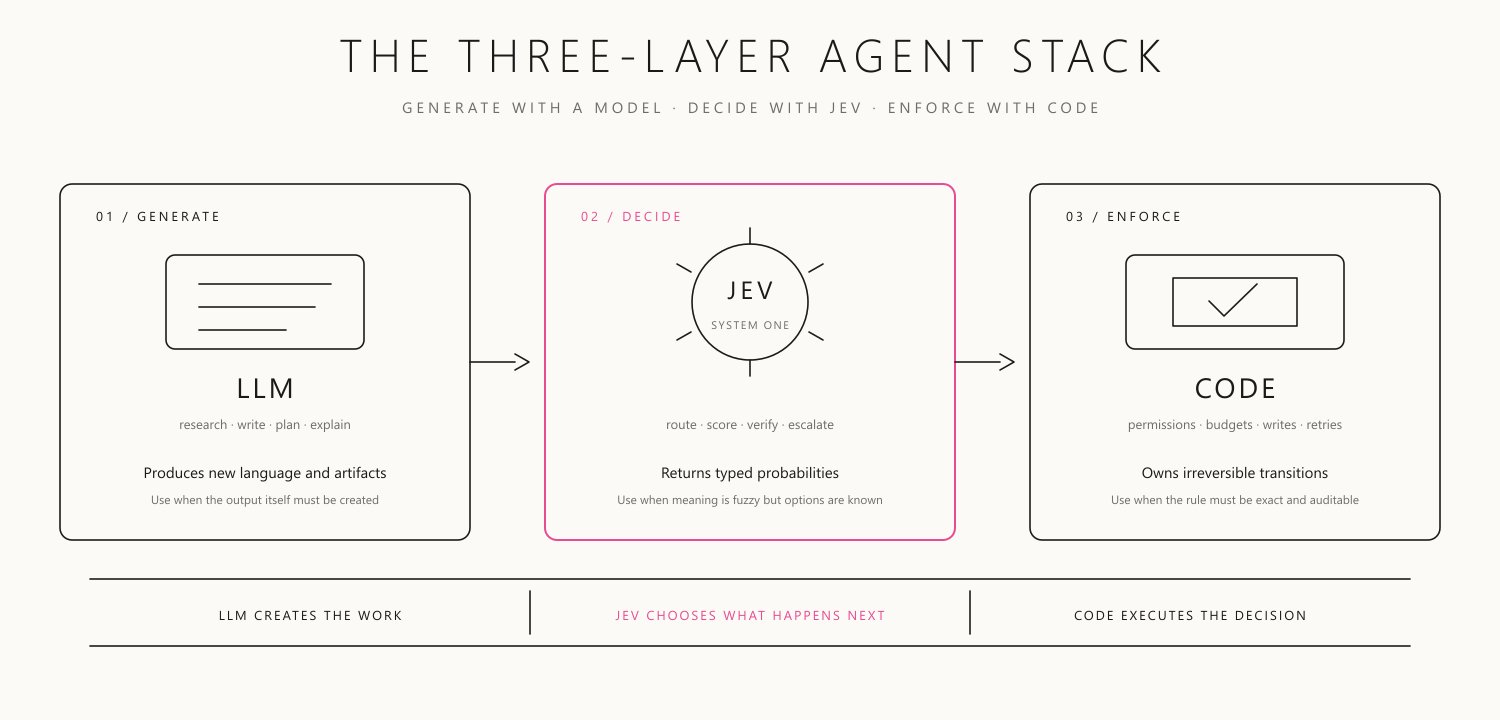
图:THE THREE-LAYER AGENT STACK(原文配图 1/3)。
最干净的架构有三个不同的归属:
GENERATE  ->  LLM
DECIDE    ->  JEV
ENFORCE   ->  CODE
LLM 负责生成
当输出本身需要被创造出来时,用生成式模型。
- 研究
- 写作
- 规划
- 代码
- 解释
- 开放式的综合
Jev 负责判断
当含义是模糊的、但可能答案的形状是已知的时候,用 Jev。
- 路由到某一个 worker
- 按评分标准打分
- 估计是或否
- 决定是否重试
- 判断是否升级
代码负责强制
当规则必须精确时,用确定性代码。
- 权限
- 预算
- 重试上限
- 账户访问
- 数据库写入
- 发布
- 删除
- 资金流动
这推导出一条有用的规则:
如果系统必须创造语言,用 LLM;如果系统必须解读含义并从已知结果中做选择,用 Jev;如果系统必须遵守某个精确的不变量,用代码。
最危险的错误,是让一个置信度分数变成许可。
Jev 可以建议一个动作。
只有 harness 才有权授权它。
Jev 有三个决策原语
Jev 刻意把接口做得很小。
这三个原语,足以搭建 Agent 内部大多数的语义分支。
Choice
当必须恰好有一个选项胜出时,用 Choice。
from typesafe_sdk import Choice

next_worker = Choice(
    instructions="Which worker should act next?",
    criteria={
        "research": "Important evidence is still missing",
        "write": "Enough evidence exists to draft the answer",
        "review": "The request is unclear, complete, or consequential",
        "none": "No listed worker is appropriate",
    },
)
结果包含:被选中的选项、一个覆盖所有选项的概率分布,以及置信度。
现实是开放的,就不要设计一个封闭的菜单。
如果选项可能不完整,就把 none、other 或者 escalate 放进去。
否则概率质量会被强行分配给「错得最少的那个答案」。
Score
当判断落在一个有序的评分标准上时,用 Score。
from typesafe_sdk import Score

evidence_quality = Score(
    instructions="How well does the evidence support the requested conclusion?",
    criteria=[
        "No direct support",
        "Partial support with important gaps",
        "Strong support from multiple independent sources",
    ],
)
输出可以落在两档之间。
但这不会把一个有序评分标准变成一次精确测量。
1.6 分不是「80% 好」。
它是你定义的那几个描述之间的一段位置。
Noul
当你需要一个是/否概率时,用 Noul。
from typesafe_sdk import Noul

requires_approval = Noul(
    instructions=(
        "Would executing the proposed action publish, purchase, delete, "
        "change permissions, or represent the user externally?"
    ),
)
结果接近 1.0 意味着大概率是;接近 0.0 意味着大概率否;接近 0.5 意味着模型无法有把握地区分。
它不意味着「中等审批风险」。
如果你需要低、中、高三档风险,用 Score。
问题本身就是程序的一部分
很多构建者会把 Jev 的问题当成随口一写的 prompt。
这会浪费掉它全部的优势。
一个生产级的问题就是一份决策契约。
它定义了:哪些证据重要、存在哪些结果、以及结果如何进入代码。
DECISION CONTRACT

state fields
question instructions
option descriptions or rubric
fallback outcome
confidence thresholds
allowed action
escalation path
version
有一个细微之处立刻就会起作用:
Jev 不会从你内部的字段名里学到任务是什么。
把一个字段命名为 safe_to_publish,并不会告诉模型什么叫做 safe。
真正的规则,必须出现在 instructions 和 criteria 里。
# weak
"safe_to_publish": Noul(
    instructions="Is this safe?"
)

# stronger
"safe_to_publish": Noul(
    instructions=(
        "Does the draft contain only verified claims with citations, avoid "
        "private information, and require no unresolved legal or financial approval?"
    )
)
键名帮助的是你的代码。
instructions 帮助的是模型。
把这两者混为一谈,就会制造看不见的 bug。
状态工程比提示词装饰更重要
Jev 只能判断你提供给它的状态。
不要丢给它一整段巨型对话,然后指望模型自己重建你的工作流。
给它做出这个判断所必需的、紧凑的证据。
state = {
    "goal": "Prepare a cited briefing on three new agent tools",
    "constraints": {
        "publish": False,
        "deadline": "09:00 UTC",
        "max_sources": 12,
    },
    "completed_work": {
        "sources_collected": 7,
        "draft_exists": True,
        "fact_check_complete": False,
    },
    "evidence": [
        {"id": "s1", "kind": "official_docs", "supports": ["pricing"]},
        {"id": "s2", "kind": "launch_post", "supports": ["availability"]},
    ],
    "available_workers": ["research", "write", "fact_check", "review"],
}
好的状态按功能分层:
GOAL         成功的定义是什么
FACTS        系统已知什么
ARTIFACTS    已经存在什么
EVIDENCE     什么在支撑下一个判断
CONSTRAINTS  系统不可以越过什么
OPTIONS      现在可以发生什么
坏的状态,把主张、指令、旧尝试和无关历史混成一坨文本。
模型可能仍然返回一个合法的类型。
它仍然可能选错——选到一个合法但错误的选项。
这是对「零幻觉」这个宣传标题最重要的一处修正:
Jev 不能破坏声明好的输出 schema。
它仍然可能在语义上出错。
类型安全消除了一类失败。
它并没有消除对证据、阈值、测试和评审的需求。
独立的问题并行问
大多数 Agent 决策是串行评估的,因为 LLM 生成天然是串行的。
Jev 的设计是:在一次请求里,用同一份状态评估多个带类型的问题。
client = TypeSafeClient(model="jev-latest")

response = client.system_one(
    state=state,
    questions={
        "next_worker": Choice(
            instructions="Which available worker should act next?",
            criteria={
                "research": "Evidence gaps remain",
                "write": "Evidence is sufficient for drafting",
                "fact_check": "A draft exists but claims need verification",
                "review": "The work is complete, unclear, or consequential",
            },
        ),
        "urgency": Score(
            instructions="How urgent is the request?",
            criteria=[
                "No time pressure",
                "Time-sensitive but can wait",
                "Immediate business impact",
            ],
        ),
        "requires_approval": Noul(
            instructions="Would the next action create an external side effect?"
        ),
    },
)
这三个问题,检查的是现实的同一份快照。
这让决策记录更容易理解:
{
  "state_version": "run_184:step_7",
  "next_worker": "fact_check",
  "next_worker_confidence": 0.91,
  "urgency_score": 1.24,
  "approval_probability": 0.82
}
并行不等于可以相互依赖。
在同一个调用里,一个问题无法消费另一个问题刚刚给出的答案。
如果第二个决策依赖一次搜索的结果,那就先做搜索、更新状态、然后再问。
边界很简单:
SAME EVIDENCE -> ask together
NEW EVIDENCE  -> update state first
置信度是路由信号
大多数系统过早地把概率压扁成一个标签:
0.51 -> YES
0.99 -> YES
这两个答案不应该获得同等的授权。
概率分布应当改变路由。
def route_decision(choice, confidence, consequence):
    if consequence == "irreversible":
        return "human_review"

    if confidence >= 0.90 and consequence == "low":
        return choice

    if confidence >= 0.70:
        return "collect_more_evidence"

    return "human_review"
这会产生三个运行区间。
高置信度、低后果
自动化这个分支。
例如:选择一个 worker、给内部队列排序、给候选名单排序。
中等置信度
先改善状态。
再取一个来源。问一个更强的模型。跑一次确定性检查。收窄选项。
低置信度或高后果
升级。
不要让系统拿着同一份证据,重复做同一个不确定的决策。
没有「不同的下一步行动」的置信度,只是装饰。
只有当 harness 把不确定性路由到某个地方,校准才真正产生价值。
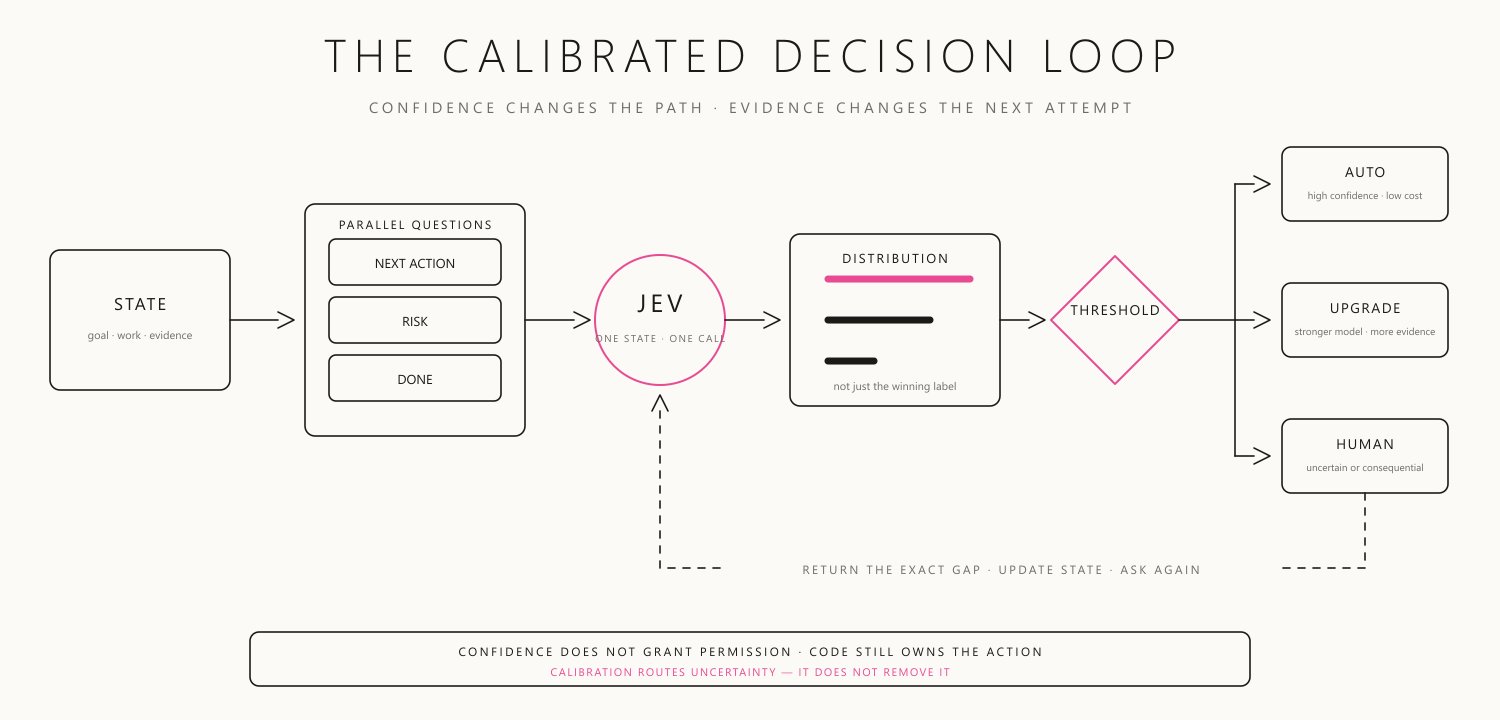
图:THE CALIBRATED DECISION LOOP(原文配图 2/3)。
Jev 属于 harness 内部
最好的 Jev 集成方式,不是把这个模型放到一切的中心。
而是把小的决策节点,放在昂贵或高风险的过渡处。
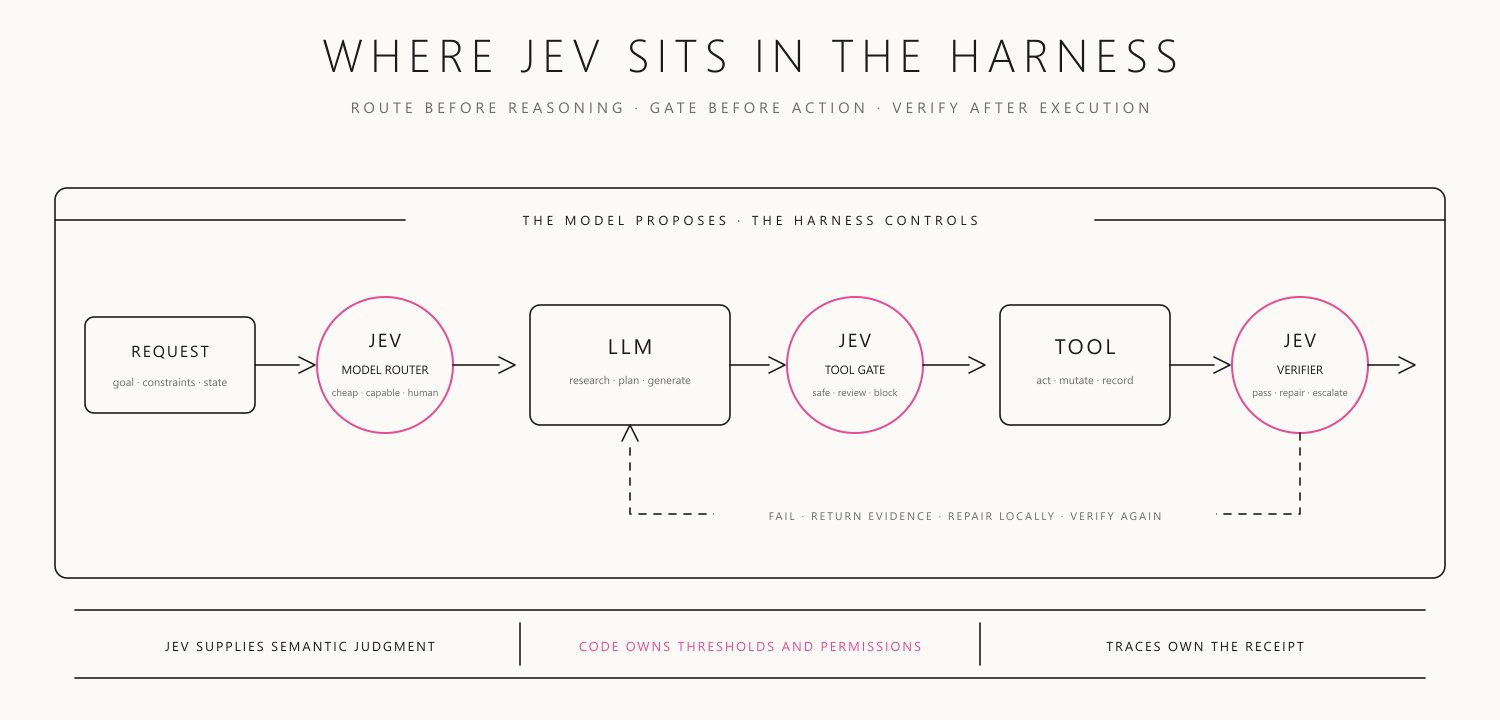
图:WHERE JEV SITS IN THE HARNESS(原文配图 3/3)。
进模型之前:给任务路由
simple classification  ->  Jev or code
routine drafting       ->  fast LLM
ambiguous research     ->  stronger LLM
high-stakes request    ->  human review
路由器应当知道当前有哪些模型可用、它们各自的能力,以及成本或延迟预算。
不要把昨天的模型菜单硬编码进一个永久 prompt 里。
进工具之前:给动作设闸
LLM 提出一次工具调用。
Jev 对它的语义风险做分类。
代码决定这个动作能否继续。
decision = classify_tool_call(proposed_call)

if decision == "allow":
    execute(proposed_call)
elif decision == "review":
    queue_for_human(proposed_call)
else:
    block(proposed_call)
Jev 不会获得发布、购买、删除或修改权限的授权。
它只向策略引擎提供判断。
工具执行之后:验证结果
一次成功的 HTTP 响应,并不能证明目标达成了。
验证器应当检查新出现的证据:
ACTION
create the report

EVIDENCE
file exists
required sections exist
claims have citations
output path is correct

DECISION
pass / repair / escalate
构建者和验证者不应共享一种模糊的「完成了」的感觉。
他们应当共享一个产物和一份评分标准。
检索环节:过滤与排序上下文
嵌入向量找到的是「主题上接近」的东西。
它们并不总能识别出「对决策相关」的证据。
一条有用的检索流水线是:
cheap deterministic filter
    ↓
embedding shortlist
    ↓
Jev relevance score
    ↓
small evidence packet
    ↓
generative model
生成式模型收到的噪声更少。
跟踪记录(trace)能显示每一项为什么被保留下来。
每一步动作之后都要重建选项菜单
最强的模式之一,出现在浏览器 Agent 里。
每一次点击之后,可用动作都会变化。
判断层应当从现在真实存在的东西里选择,而不是从运行之前写死的静态清单里选择。
controls = observe_current_page()

criteria = {
    control.id: control.semantic_description
    for control in controls
    if control.is_visible and control.is_enabled
}

question = Choice(
    instructions="Which available control best advances the current goal?",
    criteria={**criteria, "stop": "The goal is complete or no safe action exists"},
)
这个模式可以推广到浏览器之外。
worker 会上线下线。来源会失效。预算会缩水。文件会出现。权限会变化。队列会填满。
一个从过期菜单里做选择的决策模型,并不是在做一次糟糕的推理。
它是在一张已经无效的图上运行。
对于超大的选项集合:先在代码里预过滤掉明显不匹配的,再给剩下的打分,最后做一次显式的 Choice。
用 Jev 处理语义上的模糊。
不要让它去重新发现你的程序早已知道的事实。
Jev 不该做的事
新工具在被真正理解之前,通常都会被过度使用。
Jev 有清晰的边界。
不要用它生成产物
如果你需要一段解释、一封邮件、一个计划、一个程序或一份报告,用 LLM。
Jev 返回的是决策,不是散文。
不要用它处理精确规则
# use code
if attempts >= 3:
    stop()

if spend_usd > budget_usd:
    block()
语义判断不应该取代算术、日期比较、精确字符串匹配、白名单或权限检查。
不要让它凭空发明未知的值
Jev 只能从声明好的可能性中做选择。
它不是抽取引擎,不能抽取 schema 里不存在的任意名字、URL、ID 或数字。
不要把多步计划藏进一个标签里
如果一个决策需要新的证据,就先运行那个产生证据的工具。
然后再问下一个问题。
不要把类型安全当成事实正确
Jev 能保证答案符合声明好的类型。
它不能保证被选中的那个合法答案是对的。
系统仍然需要评估。
生产环境落地
不要一次性替换所有决策。
从一条高频、低后果、且正确答案日后可以被标注的分支开始。
GOOD FIRST DECISION
route an internal support ticket

BAD FIRST DECISION
approve a payment with no human review
第 1 步:定义契约
在接入模型之前,先写好状态字段、选项、标准、兜底、阈值和允许的动作。
第 2 步:构建一个有代表性的集合
包含正常样例、模糊情形、证据缺失、对抗性措辞,以及没有任何选项适配的情况。
第 3 步:影子模式运行
让现有的生产路径做真实决策。
记录 Jev 本来会选择什么。
{
  "decision_contract": "ticket-router@3",
  "state_hash": "b476...",
  "jev_model": "jev-latest",
  "answer": "technical",
  "confidence": 0.87,
  "production_answer": "technical",
  "human_label": null,
  "action_taken": false
}
第 4 步:把准确率对置信度画出来
不要只问「平均答案对不对」。
要问:在你的真实负载里,高置信度的答案是否真的比低置信度的答案更可靠。
这决定了在哪个位置自动化才是安全的。
第 5 步:自动化一条分支
从最安全的那个结果开始。
把不确定、罕见或后果重大的情况,留在现有的评审路径之后。
第 6 步:监控漂移
你的选项、用户、工具和语言都会变。
把决策契约的版本与应用代码的版本分开管理。
router@1  broad options
router@2  adds none-of-the-above
router@3  separates billing from account access
语义决策就是生产逻辑。
像对待代码变更一样对待它:评审、测试、必要时回滚。
那些看起来像模型问题、实则是架构问题的失败模式
状态里装的是结论,而不是证据
BAD
the research is probably enough

BETTER
7 sources collected · 3 official · pricing verified · security claim unresolved
模型应当判断证据。
它不应该把上一个 Agent 的置信度当成事实继承下来。
选项菜单没有逃生口
答案被迫落进几个错误选项之一。
加上 other、none、stop 或 review。
用同一个阈值控制所有后果
给一条内部备注做路由,和公开发布一份声明,不应共享同一个自动化阈值。
阈值属于动作类别,而不只是模型输出。
选项清单已经过期
被选中的 worker 已经不可用。被选中的按钮已经消失。被引用的来源已经变化。
要从实时状态重建选择集合。
同一个状态被反复重试
什么新东西都没学到。
模型还是被再问一遍。
重试应当花掉新证据,而不只是更多 token。
决策没有回执
系统只存了胜出的那个标签。
要保留:契约版本、状态引用、完整概率分布、阈值、路由,以及最终执行的动作。
策略被藏进了分类器里
问题本身在说「什么应该被允许」。
代码却盲目执行那个答案。
这把概率判断变成了无界的授权。
安全的顺序是:
JEV JUDGES
CODE CHECKS POLICY
TOOL EXECUTES
TRACE RECORDS
第一次集成就用这个顺序。
Jev 工程手册
01  Map the agent loop
02  Mark every hidden yes / no / route / score decision
03  Keep exact rules in code
04  Keep open-ended creation in the LLM
05  Choose one repeated semantic decision for Jev
06  Define state, rubric, options, and escape hatch
07  Ask independent questions in parallel
08  Route confidence into auto / improve / human paths
09  Run shadow mode and measure calibration
10  Automate the safest branch first
然后一次扩展一个边界:
FIRST
internal routing

THEN
retrieval filtering
completion verification
model selection
low-risk tool gating

LATER
consequential actions with explicit policy and approval
重点不是把 Jev 的调用次数最大化。
重点是把那些从来就不需要生成的地方,从昂贵的生成式调用里拿出来。
经济性在下游
TypeSafe 公布的价格,让判断本身变得极其便宜。
但每次调用的成本,并不是真正重要的指标。
每个完成任务的成本才是。
一个便宜的路由器把 worker 送进错误分支,可能制造出比它节省的更多的成本。
一个快速的验证器放过了劣质产出,可能在后段制造出更多延迟。
要跟踪整个系统:
decision latency
decision cost
branch accuracy
downstream tool cost
recovery cost
human review rate
completed-task rate
这正是「Jev 工程」比 Jev 本身更重要的地方。
模型提供了一个新的原语。
图决定了这个原语放在哪里。
循环决定了不确定性之后会发生什么。
harness 决定了系统被允许做什么。
而 trace 告诉你这套架构到底有没有起作用。
Jev 上线自查清单
在让一个 Jev 决策控制生产分支之前,先问:
[ ] Is this truly a semantic decision rather than generation or an exact rule
[ ] Is the state compact, current, and evidence-based
[ ] Are the instructions explicit instead of hidden in the question ID
[ ] Does every Choice include an escape hatch when the menu may be incomplete
[ ] Are Score levels ordered descriptions rather than fake measurements
[ ] Is a Noul probability interpreted as yes / no uncertainty
[ ] Are independent questions batched against the same state
[ ] Are dependent questions separated by a state update
[ ] Does confidence change the route
[ ] Are thresholds specific to the consequence of the action
[ ] Does code retain authority over permissions, budgets, and side effects
[ ] Is the decision contract versioned
[ ] Is the full distribution logged with the resulting action
[ ] Has the decision run in shadow mode on representative examples
[ ] Can the system escalate when no safe option exists
[ ] Does every retry add new evidence
如果其中有几项答「否」,说明这个系统还没准备好做更多自动化。
它准备好的是:一份更好的决策契约。
真正的变化
Jev 不是 LLM 的替代品。
它是 LLM 旁边那块一直缺失的层。
LLM
turns context into new work

JEV
turns state into typed judgment

CODE
turns judgment into controlled action
大多数构建者会继续让同一个昂贵的模型去生成、分类、路由、验证、授权和解释。
他们的 Agent 会继续把前沿模型的时间,花在那些从来不需要说成一句话的判断上。
更好的技术栈更小,也更显式:
在开放式智能能创造价值的地方用 LLM。
在软件需要一个快速语义分支的地方用 Jev。
在规则不容商量的地方用代码。
这就是 Jev 工程。
不是更聪明的 prompt。
而是智能与执行之间,一条更好的边界。
如果你读到了这里
- 订阅作者的 Substack
- 加入作者的 Telegram
- 在你往 Agent 循环里再加一次 LLM 调用之前,先把这篇文章收藏了
- 关注 @0xwhrrari
出处与版权
- 原文标题:Jev Engineering: Stop Using LLMs for Every Decision
- 作者:rari(X: @0xwhrrari,Substack: whrrari.substack.com);文中引用的发布者推文来自 Diogo Almeida(@CompleteSkeptic)与 TypeSafe AI(@typesafeai)
- 原文链接:https://x.com/0xwhrrari/status/2102020016539324501(长文实体:https://x.com/0xwhrrari/article/2102020016539324501)
- 发布/最后修改:2026-09-21(UTC)
- 抓取日期:2026-09-25(Asia/Shanghai)
- 本文为中文翻译,版权归原作者。译文保留原文的代码块、字段名、命令与 JSON 原样不译;原文的 3 张正文配图与 1 张头图原样保留(英文信息图),原文中嵌入的两条推文按可读的静态引述方式落地。
- 文中”Jev”为 TypeSafe AI 的产品名;原文提及的延迟与价格数字均为厂商口径(原文亦注明其更大的速度与成本声称属于有利工作流下的评估上限),本文未做独立核实。