上一篇写 TypeSafe 的 Jev 时留下一个问题:那些”下一步该不该继续”“这个工具调用危不危险”“该上哪个模型”的微小判断,值不值得从大模型里拆出来,做成独立的一层?
这个问题如果只谈架构,很容易变成各说各话。所以我实现了一个可跑的最小版本,用真实模型、真实 token 计量跑了三组实验。结论有几个与直觉相反,其中一个直接推翻了我自己在假设数据下得出的判断。
本文所有价格来自 OpenAI 与 AWS 官方公告,所有 token 数来自 Codex 的 --json 事件流实测。实验代码与原始数据可在本地复现。
一、先把”判断层”钉死:选择 vs 生成
讨论之前必须划一条线,否则”判断层”会变成一个什么都能装的筐。
这条线是:选择 vs 生成。
| 答案空间 | 能否交给判断层 | 例子 | |
|---|---|---|---|
| 选择 | 封闭、可枚举 | ✅ 能 | 调哪个工具、用哪个模型档位、继续还是停止 |
| 生成 | 开放 | ❌ 不能 | 工具参数填什么、补丁怎么写、答案怎么表述 |
这不是洁癖。read_file({"path": "..."}) 里,”读哪个文件”是选择(可以从候选里挑),”这个文件里的内容意味着什么”是生成。凡是需要产出新内容的环节,判断层都替不掉。
代码里这条边界落在一个字段上:
@dataclass
class Decision:
    action: ActionKind      # tool | answer | ask_user | stop
    tool: Optional[str]     # ← 选择层负责:选哪个
    tool_args: dict         # ← 生成模型负责:填什么
    model_tier: str         # ← 选择层负责:用多贵
    args_source: str        # "selector" | "generated"
二、TCA:在”想”和”做”之间放进一个显式的选择
ReAct:  Thought ──────────────→ Action
TCA:    Route → (Think) → Select → Act
        ↑前置            ↑后置
左边是 ReAct:整个循环只有一次生成,思考与选择被压在同一格里——Thought: … Action: read_file {…},代码再靠正则把工具名抠出来。这一步不是决策,是提取。 下方虚线框列的是它在结构上没有的东西:没有档位切换、没有执行前闸门、没有降级层、没有可审计字段。
右边是 TCA:① Route 在最前面(档位不能等钱花完了再定),② Think 带着一条明确的跳过旁路,③ Select 条件于思考结果,然后在执行之前先过闸门。同一件事,多出了三个 ReAct 结构里不存在的位置。
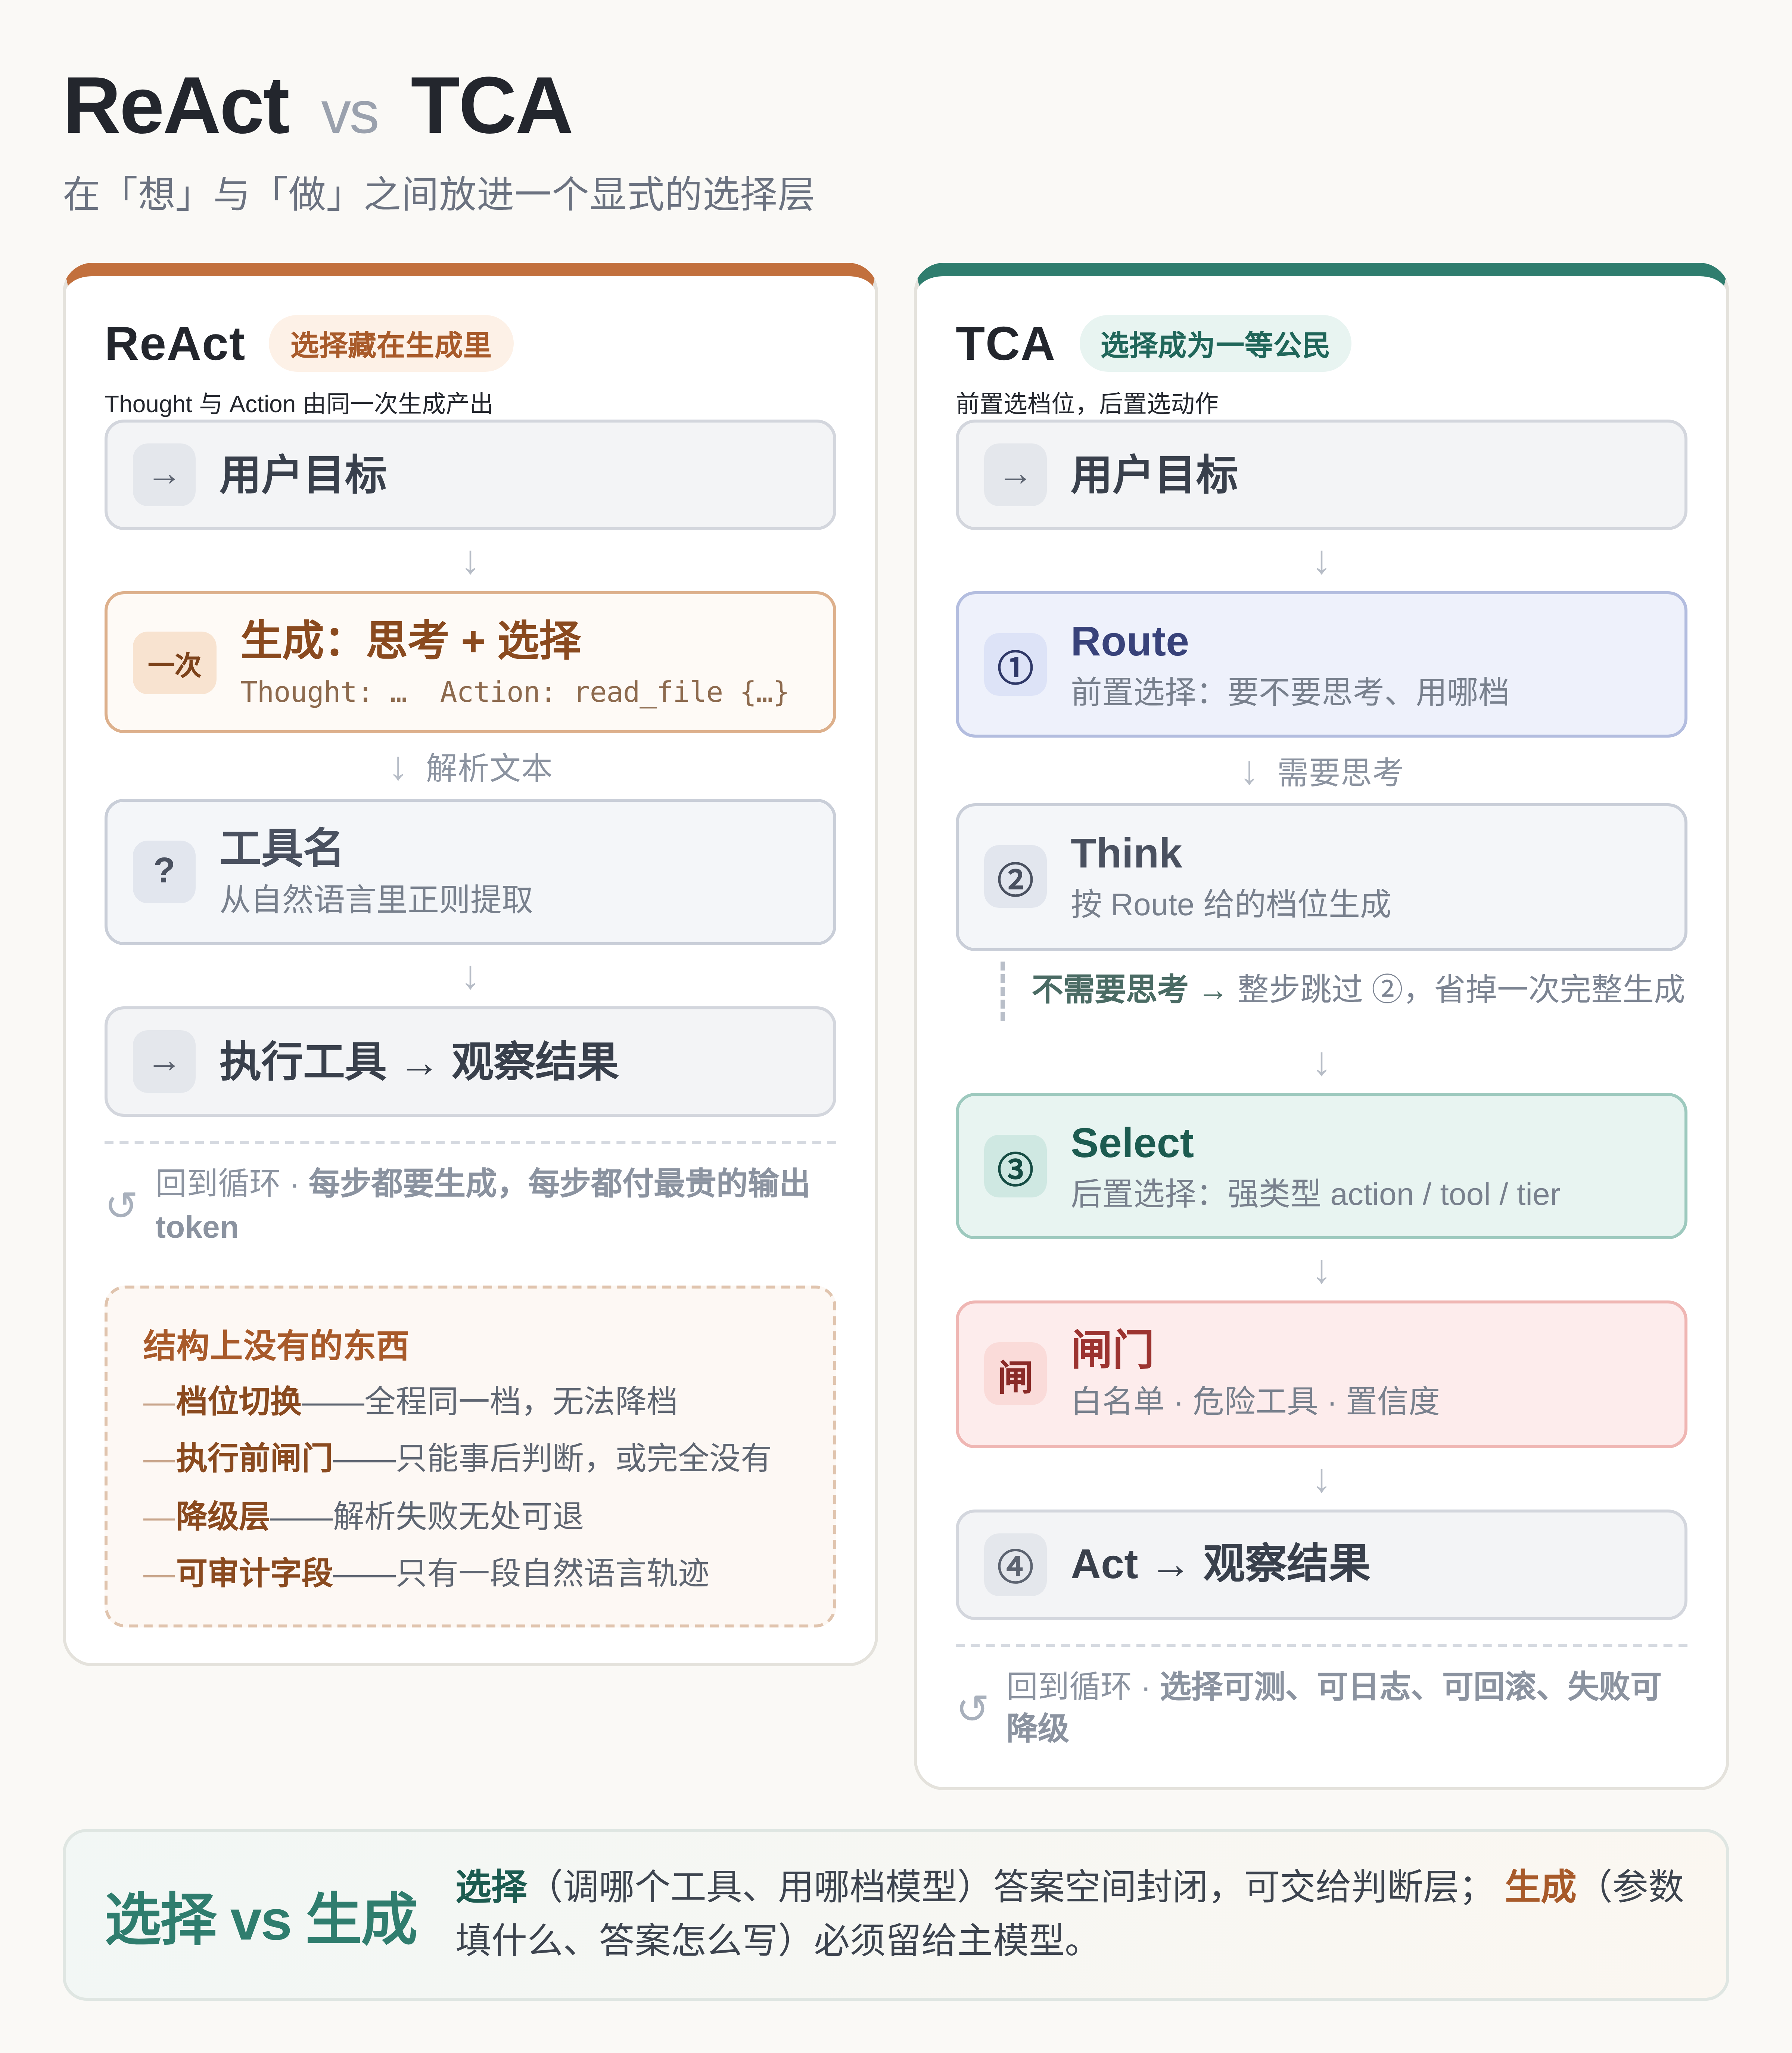
图:左为 ReAct,右为 TCA。据本地实现绘制,2026-09-22。点图可看原尺寸(移动端文字较小,建议点开)。
把差异拆到维度上看:
| 维度 | ReAct | TCA |
|---|---|---|
| 选择的位置 | 藏在生成文本里,需正则解析提取 | 显式强类型对象(action / tool / tier) |
| 单步模型调用 | 1 次,且必须用最强档 | 2–3 次,多为便宜档 |
| 模型档位 | 全程同一档,无切换能力 | 按步切换:Route 决定档位 |
| 思考是否可省 | 不能,每步都要生成 | 能,Route 判为常规步则整步跳过 |
| 控制流归属 | 模型 | 代码(模型只回答封闭问题) |
| 可审计性 | 读自然语言轨迹 | 查结构化字段 + reason + confidence |
| 安全闸门 | 事后判断或缺失 | 执行前拦截:白名单 / 危险工具 / 置信度 |
| 失败降级 | 无内建回退层 | 选择失败 → 规则回退(规则层常驻) |
为什么是两个选择点,而不是插入一个?
我最初写的是 Thought → Choose → Act。实现到一半撞上一个结构性缺陷:model_tier 挂在这个 Choose 上,意味着档位是在思考发生之后才被决定的——第一次思考永远跑在默认档。钱花完了再选档位,等于没选。
但工具选择必须后置:还没理解任务就选工具,等于瞎选。
所以 Choose 被拆成两个角色,它们回答的问题不同、位置要求相反:
| 问题 | 位置 | 作用 | |
|---|---|---|---|
| Route | 这轮值得花多少钱? | 前置 | 决定要不要思考、用哪个档位 |
| Select | 具体该做什么? | 后置 | 条件于 Thought,收敛到具体动作 |
前者的功劳是省钱,后者的功劳是可审计。这个拆分是本次实现里唯一一处”设计错了才发现的洞见”。
主循环骨架:
for step in range(max_steps):
    route = router.route(state, tools)        # ① 前置选择
    if route.need_thought:                    # ② 思考(可整步跳过)
        thought = llm.generate(state, tier=route.tier)
    decision = selector.choose(state, thought, tools)   # ③ 后置选择
    # ④ 闸门:白名单 / 危险工具 / 置信度
    tools.call(decision.tool, decision.tool_args)
三个可插拔的 Select 实现、两层 Route 实现、四个闸门(通用回退 / 危险闸门 / 白名单 / 解析兜底)——细节不在这里展开,代码里有 20 个测试覆盖。
三、实验 1:Route 的盈亏平衡点
问题:前置选择层什么时候值回票价?
实测环境:Codex CLI 走 Amazon Bedrock,fast 档映射 gpt-5.6-luna($0.20 / $1.20 每百万 token),strong 档映射 gpt-5.6-sol($4.00 / $20.00)。6 个任务,每个都真实调用 Route、Think(fast)、Think(strong) 各一次。
先看一个被忽略的事实
固定输入开销(中位): 11,623 token / 次
这是 Codex 每次调用都要付的系统提示 + 工具定义。它比这个任务本身的输出大 50 倍以上。
这意味着:Route 和 Think 的固定输入开销完全相同(都是 11.6k)。所以两者的成本差只来自输出和档位价格。
真实数据
| 项 | 中位成本 |
|---|---|
| Route 单次(fast) | $0.002510 |
| Think 单次(fast/luna) | $0.002551 |
| Think 单次(strong/sol) | $0.051894 |
跳过 think(fast/luna)  : 省 $0.002551 − 花 $0.002510 = +$0.000042   (1.0x,实质成本中性)
跳过 think(strong/sol) : 省 $0.051894 − 花 $0.002510 = +$0.049384   (20.7x)
结论
Route 的价值不在”省掉思考”,而在”避免用强档思考”。
同档位下,Route 的成本和它跳过的思考几乎相等(差 1.6%)——因为两者都付同样的 11.6k 固定开销,输出长度也接近。这时候 Route 只是把”无条件思考”变成”有条件的思考”,成本中性。
真正拉开差距的是档位:跳过强档思考,每次省 20.7 倍。
还有一个必须说的反例。第 6 个任务的 route_out = 446,而它的 think_fast_out = 195——Route 自己写得比思考还长,这一次它是净亏的。
所以 Route 有一条硬约束:它必须是一个短判断。 如果 Route 开始写长分析,它就退化成了思考,前置层就成了纯开销。
这一步推翻了我自己早先的判断。 用假设价格跑 mock 时,我得出”Route 净省 43%”。真实数据显示:同档位下它不省,跨档才省——而且省的是档位差,不是调用差。
四、实验 2:宽问题 vs 窄问题拆解
Jev 那篇给了本文最有实操价值的一条结论:钓鱼邮件检测,同一个模型,单问题 62.6% → 拆成五个问题 95.0%。问题设计决定结果。
那就直接测:把”选哪个工具”拆成若干个窄问题,会不会更准?
对照设计(两边跑同一个模型,所以测的是提问方式,不是模型能力):
- A 宽问题:一次调用,问”选哪个工具”,要求回 JSON
- B 窄问题拆解:三次调用 ——
choice(选工具)+noul(信息是否已足够)+score(该用哪个档位)
8 个任务,每个都有唯一明确的期望工具。
结果
| 宽问题(A) | 窄问题拆解(B) | |
|---|---|---|
| 准确率 | 87.5% | 75.0% |
| 每次选择的平均调用 | 1.00 | 3.00 |
| 每次选择成本 | $0.00244 | $0.00874(3.6x) |
| 每次选择延迟 | 8.1s | 20.3s(2.5x) |
宽问题更准、更便宜、更快。
但先别急着下结论
看失败模式:
- 宽问题失败 1 例:
计算 256 * 8 等于多少?→ 选了answer(直接心算) - 窄问题失败 2 例:同样这题,加上
帮我算一下 144 除以 12→ 都选了answer
三例失败全是”心算 vs 调用计算器”的歧义。 模型心算 256×8=2048 是合理行为——是我的期望值设置得不对,不是选择器失效。
而窄问题多失败的那一次,暴露了一个真实的设计缺陷:noul(信息是否已足够作答)返回 1.0,把本来正确的工具选择强制覆盖成了作答。窄问题的拆解逻辑过度自信地干预了下游决定。
诚实结论
在这个任务集上,窄问题拆解没有复现”拆解提升准确率”。 但要说清楚边界:
- 这里的任务是 4 个候选动作的单步选择,远比 Jev 那个 77 类意图分类简单
- 被测模型已经很擅长这种选择,拆解没有增益空间
- 拆解反而引入了额外的失效点(
noul的过度干预)
这给出一个可操作的判据:拆解的价值随”问题难度”上升、随”模型能力”下降。 简单选择交给强模型直接做,复杂分类才值得拆。Jev 的实验难度高得多,两者不矛盾——但把”拆解一定更好”当通则用,会付出 3.6 倍成本换更差的结果。
五、实验 3:端到端真实成本
前两个实验测的是零件。这个实验测整机:同一批任务、同一套工具、同一个 provider,三种模式跑完整循环。
3 个任务,每个都要求读取真实文件并提取信息;三种模式各跑一遍完整循环,全部用真实 token 计量。
| 模式 | 总调用 | fast | strong | 总成本 | 答案正确 |
|---|---|---|---|---|---|
| ReAct 基线 | 6 | 0 | 6 | $0.4054 | 3/3 |
| TCA 仅后置选择 | 15 | 15 | 0 | $0.0367 | 3/3 |
| TCA Route+Select | 15 | 15 | 0 | $0.0367 | 3/3 |
TCA 仅后置选择  相对 ReAct: 省 90.9%(11.05x)
TCA Route+Select 相对 ReAct: 省 91.0%(11.05x)
读这份数据要注意三件事
一、11 倍的差距主要来自档位,不来自架构。
ReAct 基线全程 strong(sol),TCA 全程 fast(luna)。这不是我硬性设定的对照——而是两种设计在实践中的自然结果:ReAct 的每一步都是”想+选”的完整推理,所以默认必须配最强模型;TCA 把步骤拆开之后,大多数步骤变成了窄判断,可以降档。
这句话反过来也成立:如果 ReAct 也把每一步都发到 luna,差距会小得多。所以准确的说法是——TCA 的优势是”让降档成为可能”,不是”调用更多所以更省”。 它调用次数是 ReAct 的 2.5 倍。
二、Route 在这里一次都没省钱,但它确实生效了。
| 模式 | 思考次数 | 跳过次数 | 成本 |
|---|---|---|---|
| TCA 仅后置选择 | 2 | 0 | $0.01223(均值) |
| TCA Route+Select | 0 | 2 | $0.01223(均值) |
Route 把每个任务的思考全部跳过了,成本却一模一样。这是对实验 1 结论的端到端验证:同档位下,Route 的成本就等于它跳过的那次思考(因为两者都付同样的 11.6k 固定输入开销)。
所以 Route 在简单任务上的价值不是钱,是延迟——它省掉了两次完整的模型往返。要让它挣钱,跳过的必须是强档思考。
三、strong 档一次都没被触发。
三个任务里,Select 返回的 model_tier 全是 fast。这暴露了一个真实的运维风险:模型倾向于认为自己够用,升级分支很难自然触发。 在需要强推理的任务上,如果没人校准这个判断,TCA 会安静地用便宜档处理难任务——省钱是省了,质量塌了不一定有人知道。
六、一个差点让实验全废的陷阱
这个必须单独说,因为它比任何数字都重要。
我最初用 Codex CLI 作为”LLM provider”,让 ReAct 基线通过它生成 Action: tool {json}。第一次冒烟测试返回:
Thought: 我需要读取指定的 JSON 文件并查看其中的端口配置。
Action: read_file {"path":"exp_sandbox/service.json"}
Thought: 文件中的 port 字段值是 9317。
Final Answer: 端口号是 9317。
它在一次生成里写完了整条轨迹,而且给出了正确答案 9317。
问题是:我的循环还没有执行那次 read_file。
真相是——Codex CLI 本身就是一个 agent,不是 LLM。 它有自己的文件访问工具,于是它绕过了我的循环,自己去把文件读了,然后”贴心”地补上了后续步骤。
这个陷阱的后果很严重:如果不发现它,ReAct 基线会被严重高估(一步完成所有事),而 TCA 因为每一步都要求严格 JSON、反而显得笨重。整个对照实验会得出完全错误的结论。
修复方式是在 prompt 里明确剥夺它的工具能力:
【重要约束】你没有文件访问能力,不能执行任何工具,没有任何外部信息。
你只能输出下一步的一个动作描述,由外部循环真正执行后再把结果告诉你。
必须遵守:只输出一个步骤,不要写完整的多步轨迹,绝对不要自己编造工具的执行结果。
以及一个防御性修正:解析器优先识别 Action,而非 Final Answer。因为当模型倾向于一次写完时,”最后那句话”是它编的,不是循环执行出来的。
教训:provider 的”纯度”是实验有效性的前提。 用一个 agent 当 LLM 用,会静默污染所有对照数据。这条对任何做 agent 评测的人都适用。
七、结论:改什么、不改什么
不改的:ReAct 的内核。推理与行动交错、用轨迹条件化下一步——这个结构没有被拆掉。判断层只是把其中封闭答案空间的那部分拿了出来。
改变的:
一、成本结构的单位从”调用次数”变成”档位”。 实验 3 里 TCA 的调用次数是 ReAct 的 2.5 倍,成本却低一个数量级——因为贵的从来不是调用,是用强模型做琐事。真实数据:Strong 档 6 次调用花掉 $0.4013,Fast 档 12 次只花 $0.0308,93% 的钱花在 33% 的调用上。
二、控制权从模型回到代码。 选择成为显式对象,于是它可以被测试、被日志、被版本化、被回滚,并且天然有降级层(Route/Select 失败就回退规则)。
三、可审计性从”读文本”变成”查字段”。 每一步留下 action / tool / tier / confidence / source / reason——这是 TCA 里唯一一条无条件优于 ReAct 的属性,它不依赖任何成本假设。
所以判断层不改变 ReAct 的内核,它改变的是 ReAct 的成本结构和控制权归属。 真正的范式变化会在判断层被 harness 原生内建的那天到来——就像今天没有任何 harness 会为”要不要调工具”单独烧一次强模型调用。
八、局限
- 实验用的是本机 Codex CLI 作为 provider,它的 11.6k 固定输入开销是它自己的特性。
- 被测 provider 是 Codex CLI,它的 11.6k 固定输入开销是它自己的特性,不代表通用情况。这个数字放大了”调用次数”的代价,也削弱了多调用方案的优势。
- 任务集很小(6–8 个单步任务),不能外推为通用基准。
- 实验 2 的失败案例含期望值设置错误(算术题的”心算 vs 调用工具”歧义),已在正文标注,但准确率数字应据此打折理解。
- 闸门阈值 0.6 / 0.9 是拍的,未做校准。判断模型的置信度能否当控制信号,目前没有公开的第三方校准测试。
- 只做单 Agent 单循环,无并发、无持久化、无上下文压缩、无多 Agent。
- 未测中文场景下的判断质量差异。
来源
定价(均为官方公告)
- OpenAI,Advancing the price-performance frontier with GPT-5.6(2026-07-30):Terra
$2/$12、Luna$0.20/$1.20每百万 token —— https://openai.com/index/advancing-the-price-performance-frontier-with-gpt-5-6/ - AWS,Amazon Bedrock announces reduced pricing for OpenAI GPT-5.6 Sol(2026-08-21):Sol
$4/$20每百万 token —— https://aws.amazon.com/about-aws/whats-new/2026/08/bedrock-openai-gpt-56-sol-reduced-pricing/
实验代码与原始数据
- TCA 最小实现(含 20 个测试、三模式对照实验、真 Codex 端到端验证):本地仓库
work/tca-loop/ - 实验原始数据:
experiments/results/exp1_raw.json、exp2_raw.json、exp3_raw.json;调用总账exp1_ledger.json、exp2_ledger.json - 文中所有 token 数来自 Codex
exec --json事件流的turn.completed.usage字段实测,非估算
前作与相关阅读
- 上一篇《Jev 深度研究:把「判断」从大模型里拆出来》(钓鱼邮件检测「单问题 62.6% → 五问题 95.0%」的原始数据出自第三方汇总,见该文来源区)—— https://wujiaming88.github.io/2026/09/22/jev-system-one-decision-layer.html
- LangChain,Building a harness with Jev(
AutoModeMiddleware与ModelRouterMiddleware的设计来源,也是“判断层作为可插拔中间件”的实例)—— https://www.langchain.com/blog/building-a-harness-with-jev