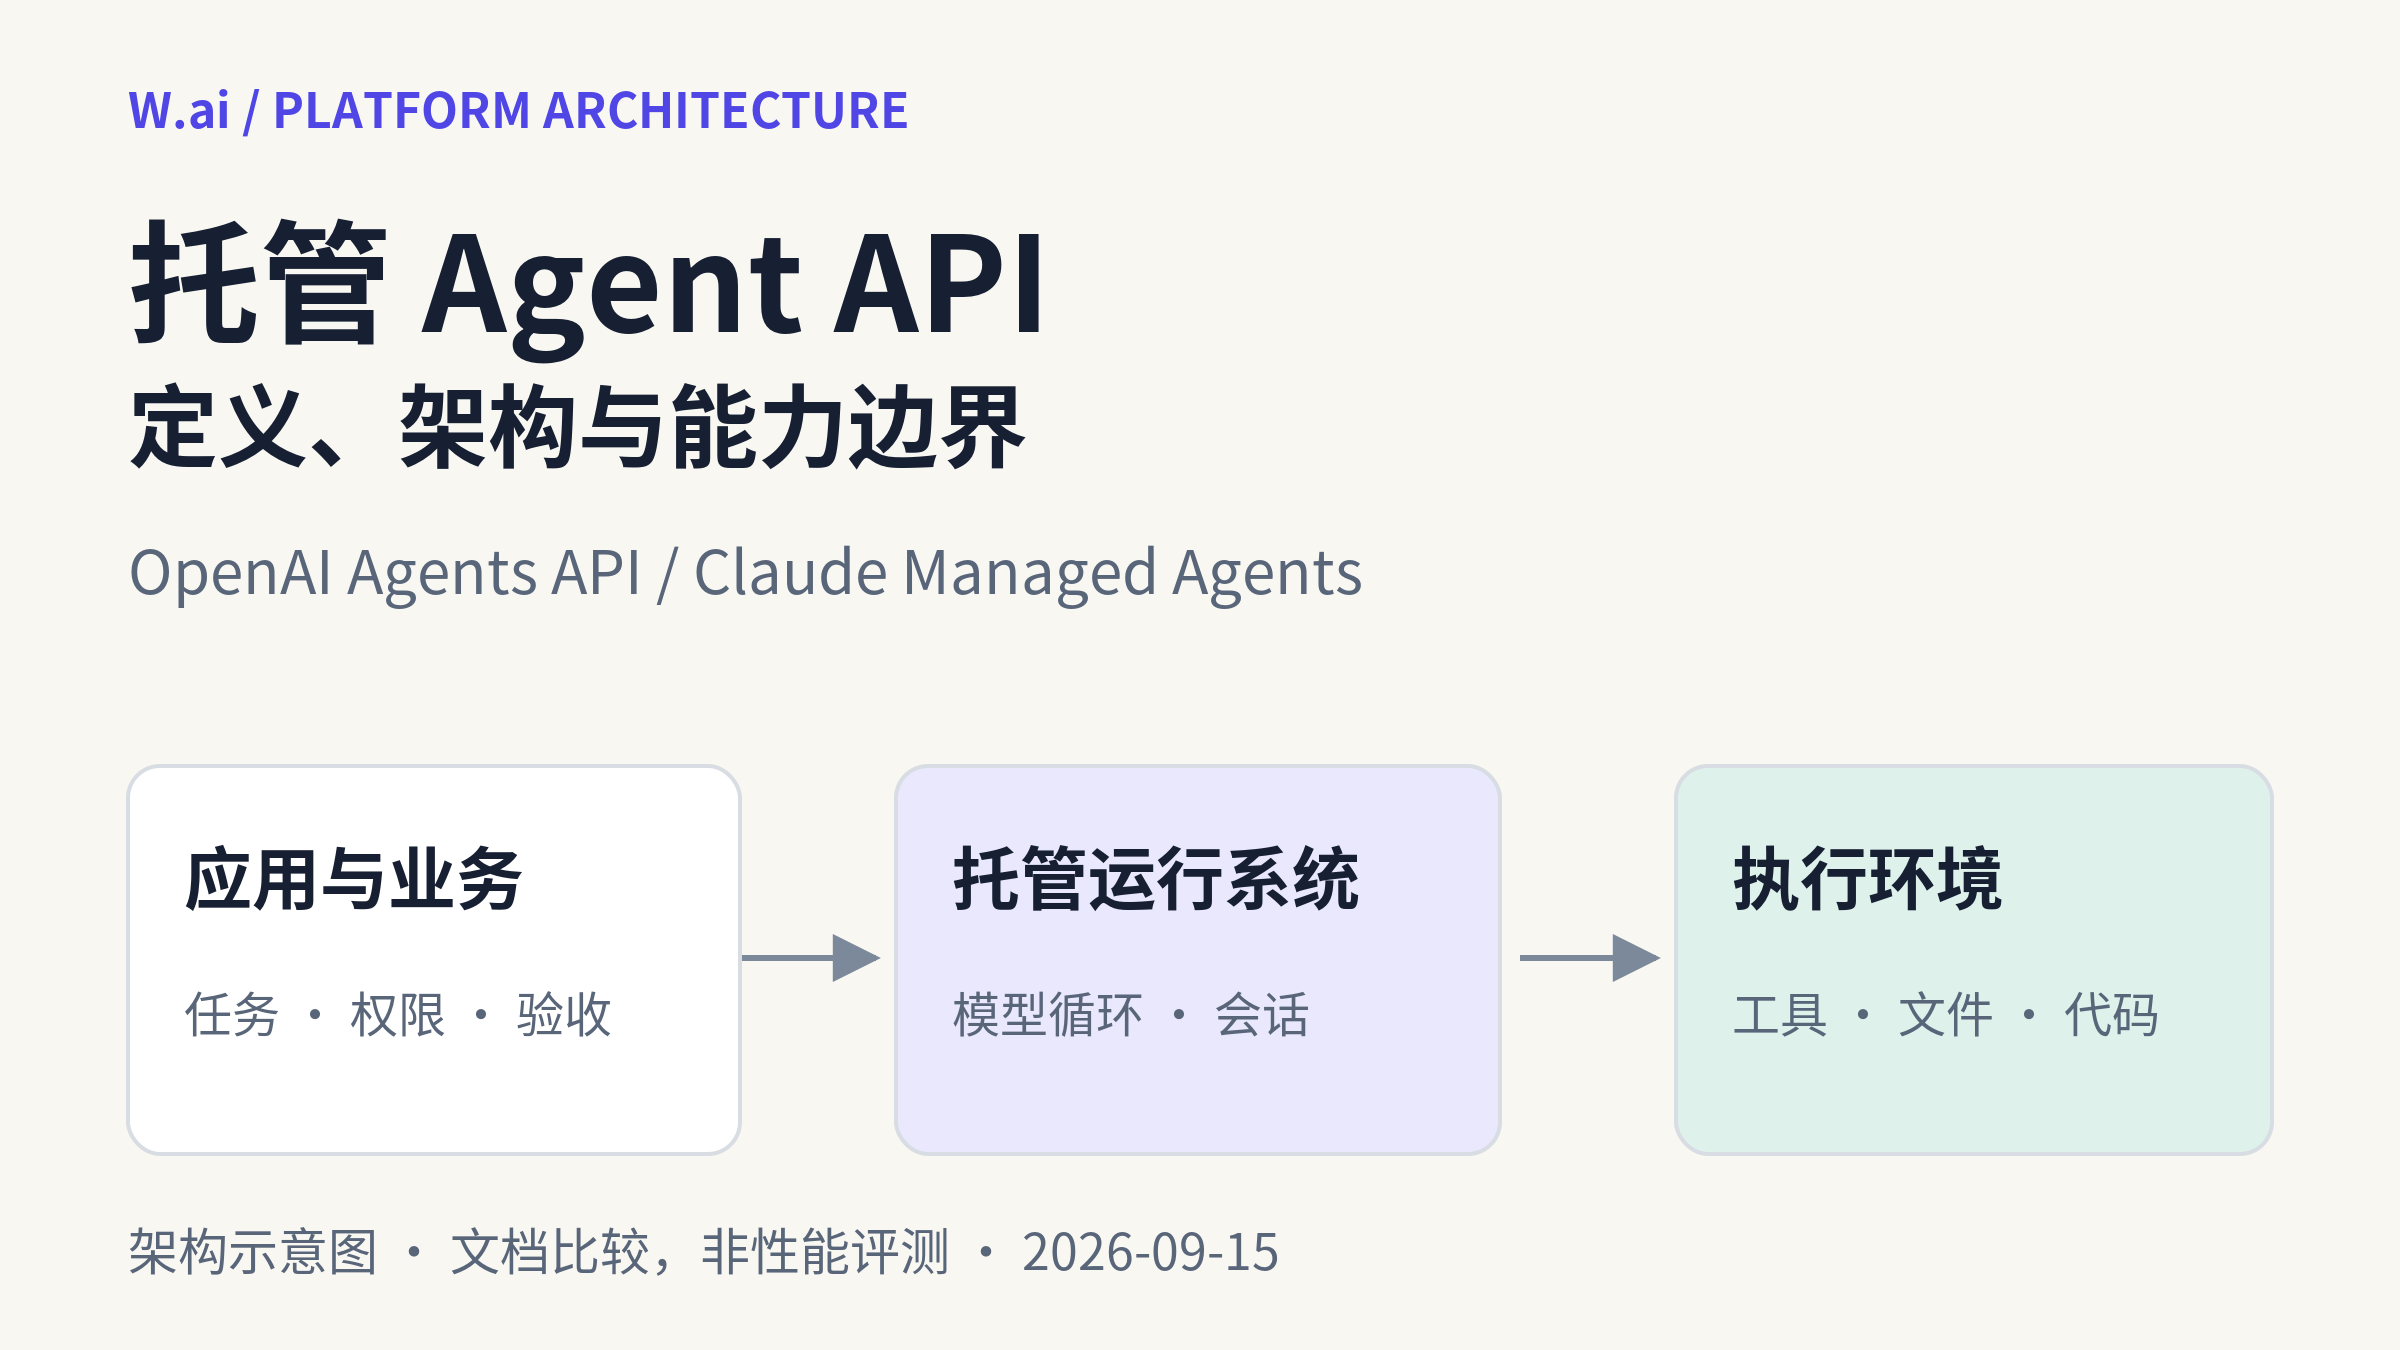
OpenAI Agents API 与 Claude Managed Agents 托管的,不只是一次模型回答,而是 Agent 持续使用工具、保存工作状态并推进任务的运行系统。两者都把模型调用循环、上下文管理、工具编排和多 Agent 协作交给厂商;主要差异在于执行环境如何组织,哪些工作流能力成为原生资源,以及应用仍要承担哪些治理与交付责任。
OpenAI 于 2026 年 9 月 10 日推出公开 beta 的 Agents API,开放 Codex 的核心运行系统。Anthropic 的 Claude Managed Agents 同样处于 beta,文档注明 API 账号默认开放,部分能力另有限定 preview;会话、执行环境、定时部署、跨会话记忆和结果评审已纳入其产品范围。[O1][A1][A2][A3][A4]
本文依据截至 2026 年 9 月 15 日(Asia/Shanghai)的官方公告、产品指南、定价与安全文档,属于文档比较,未做付费 API 实测。
托管的是运行系统
模型 API、Agent SDK 和托管 Agent API 是三个不同层次。它们都可以用于构建 Agent,但向开发者交付的内容不同。
| 产品层次 | OpenAI | Anthropic | 应用的主要责任 |
|---|---|---|---|
| 模型接口 | Responses API 等 | Messages API | 决定循环、执行工具、管理状态与恢复 |
| 自行运行的框架 | Agents SDK | Claude Agent SDK | 使用框架组织 Agent,自行承担部署与运行 |
| 托管运行服务 | Agents API | Claude Managed Agents | 配置任务与工具,选择执行环境,管理业务权限和验收 |
模型接口提供调用能力,SDK 提供程序框架,托管服务则由厂商运行 Agent 的核心循环和会话系统。因此,Agents API 不是 Agents SDK 改名,Managed Agents 也不是 Claude Code 订阅的远程包装。两项托管产品的参数、事件、定价与数据政策,须按各自文档判断,不能把普通模型 API、SDK 或历史营销页的能力自动算到新的托管 API 上。
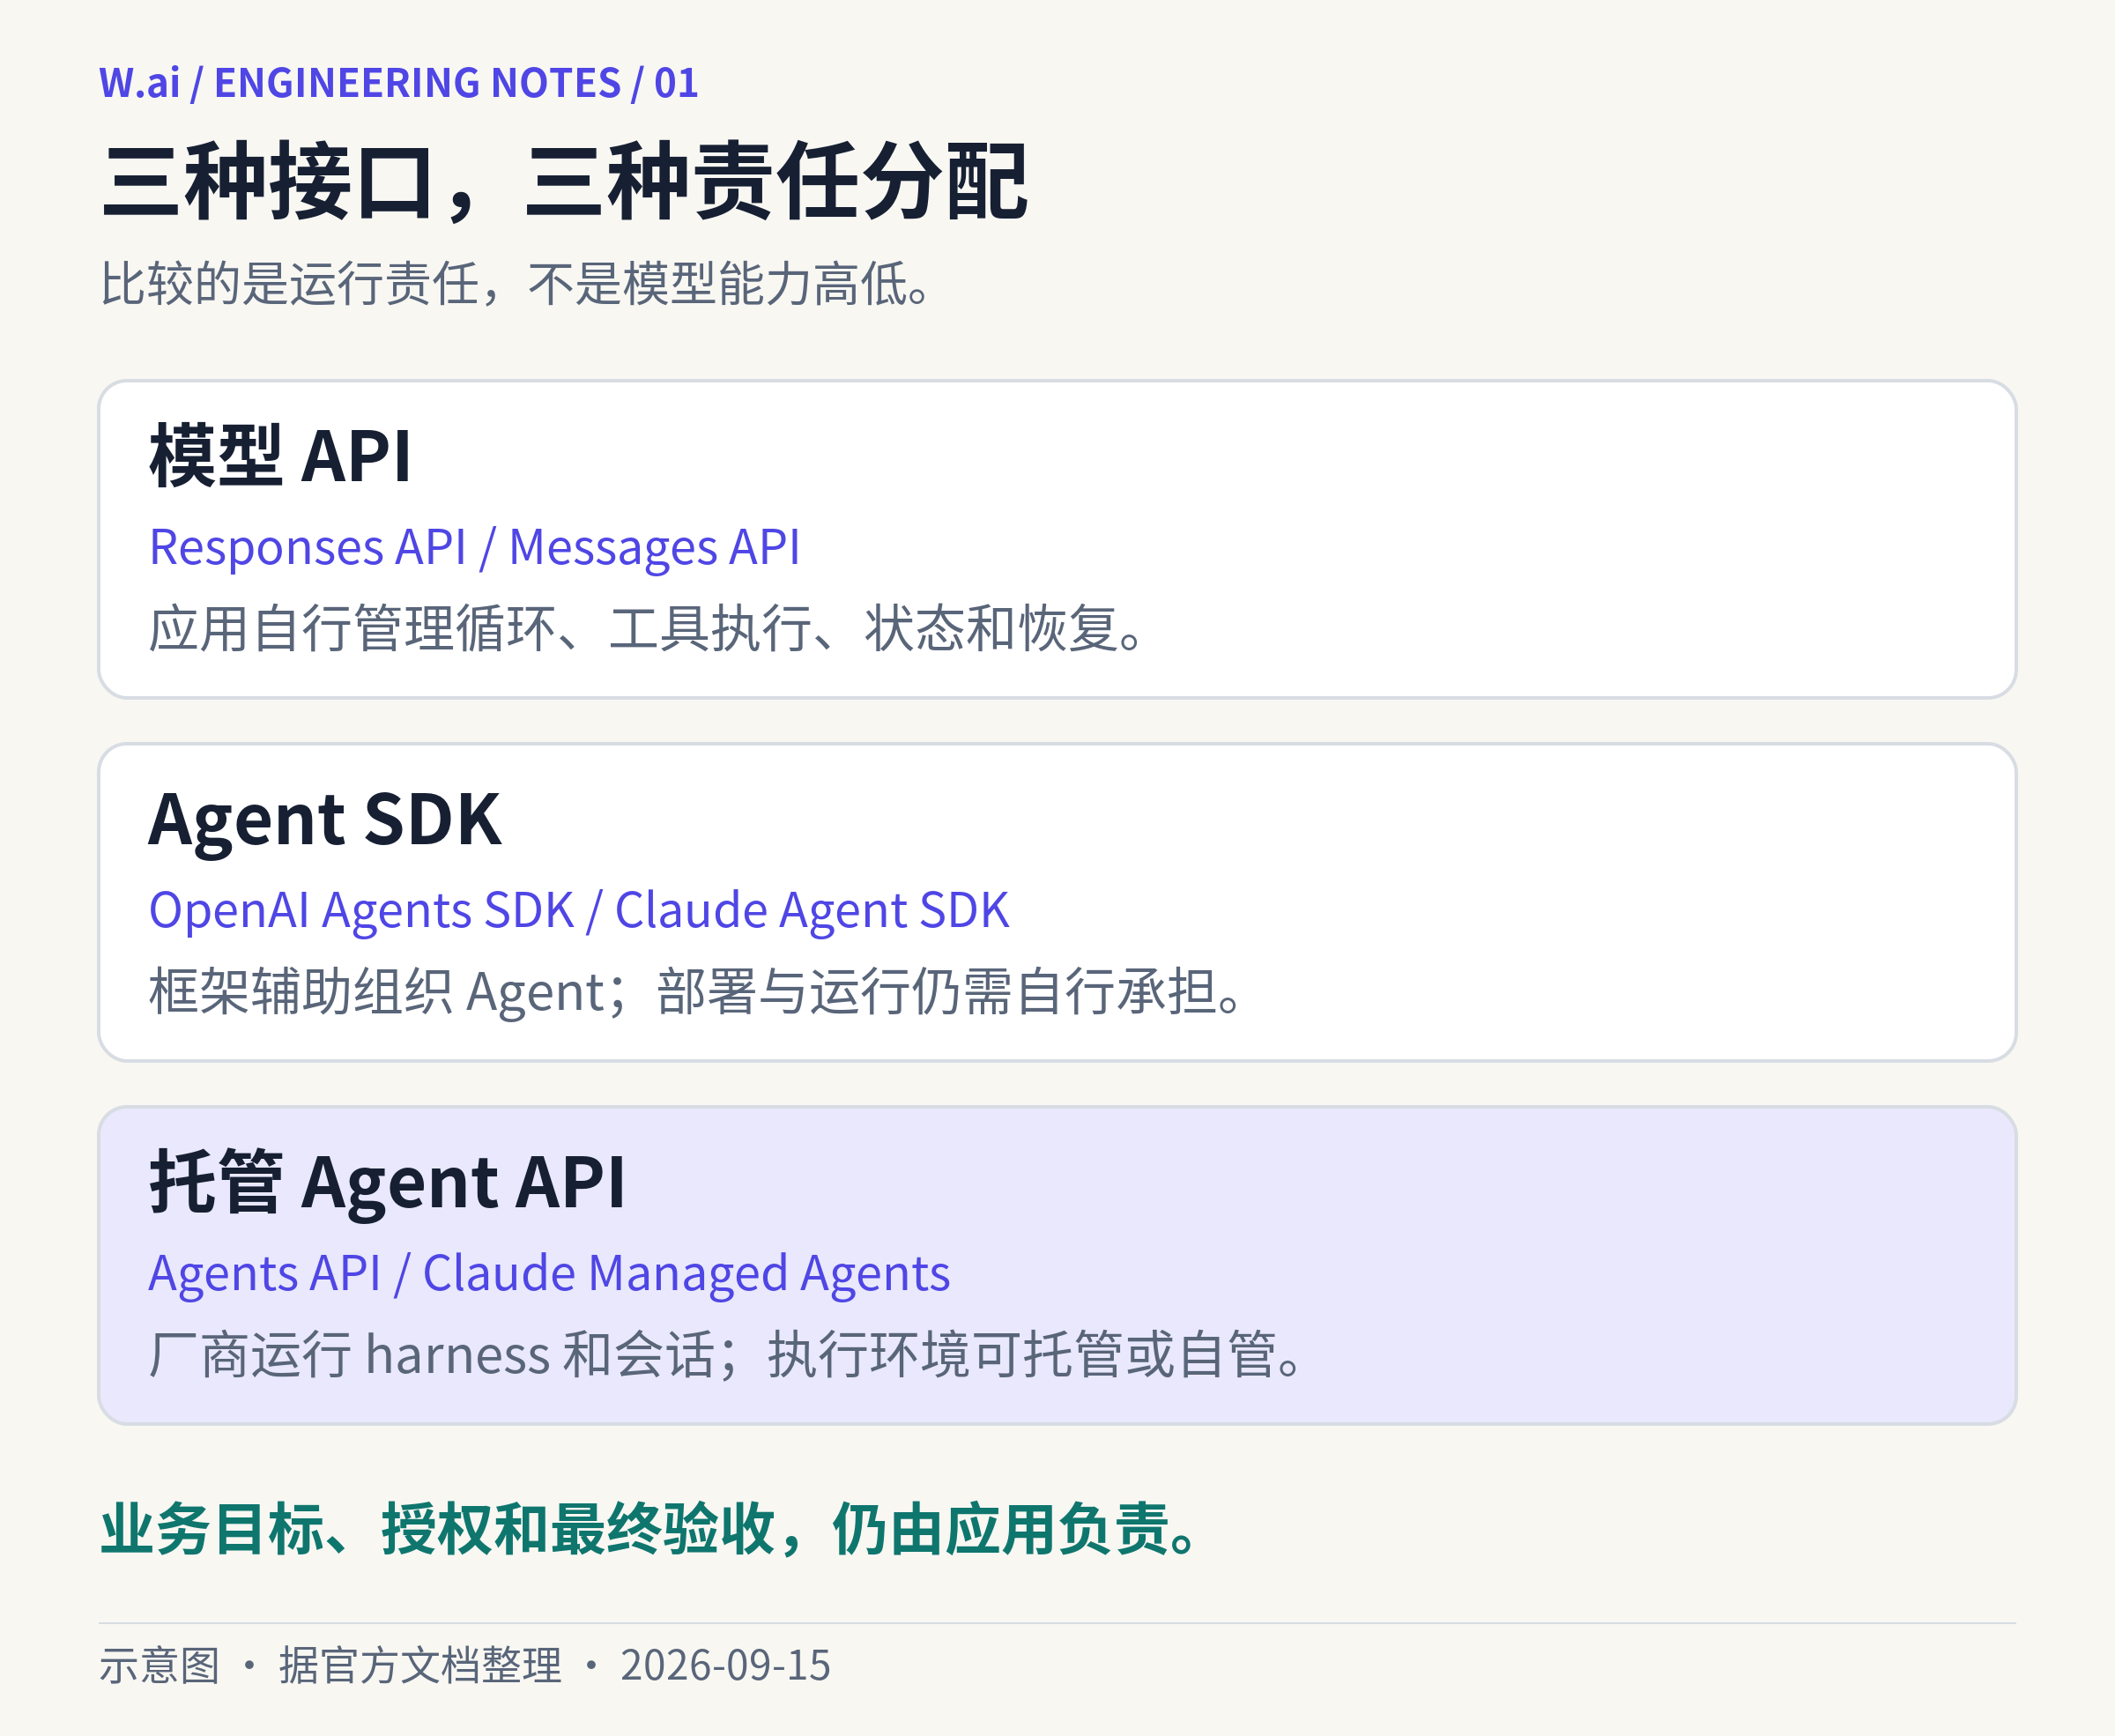
图 1|三种接口的责任分配示意图。根据 OpenAI 架构指南与 Claude Managed Agents 概览整理,2026-09-15。图中比较运行责任,不表示模型能力高低。
两项服务都使用 Agent、Environment、Session、Events 等原语;OpenAI 还列出 Items。[O2][O5][A1]
这不是简单保存聊天历史:会话、执行环境和业务结果有不同的生命周期。保存 session、压缩上下文或存储文件,也不能直接等同于一套有版本与权限治理的跨会话记忆系统。运行系统、所选模型、工具质量与业务验收,仍是不同的问题。
执行环境与工具协作
两家都把控制面与执行环境分开。厂商运行模型调用和工具循环,维护上下文与会话;应用提交任务、接收事件、处理业务工具,并选择命令和文件操作在哪里执行。
自托管只改变执行位置,不把模型与控制面一起搬回本地。 工具输入输出仍会进入厂商系统;访问内部网络,不代表业务数据不会流出内部网络。[O3][O7][A9][A10]
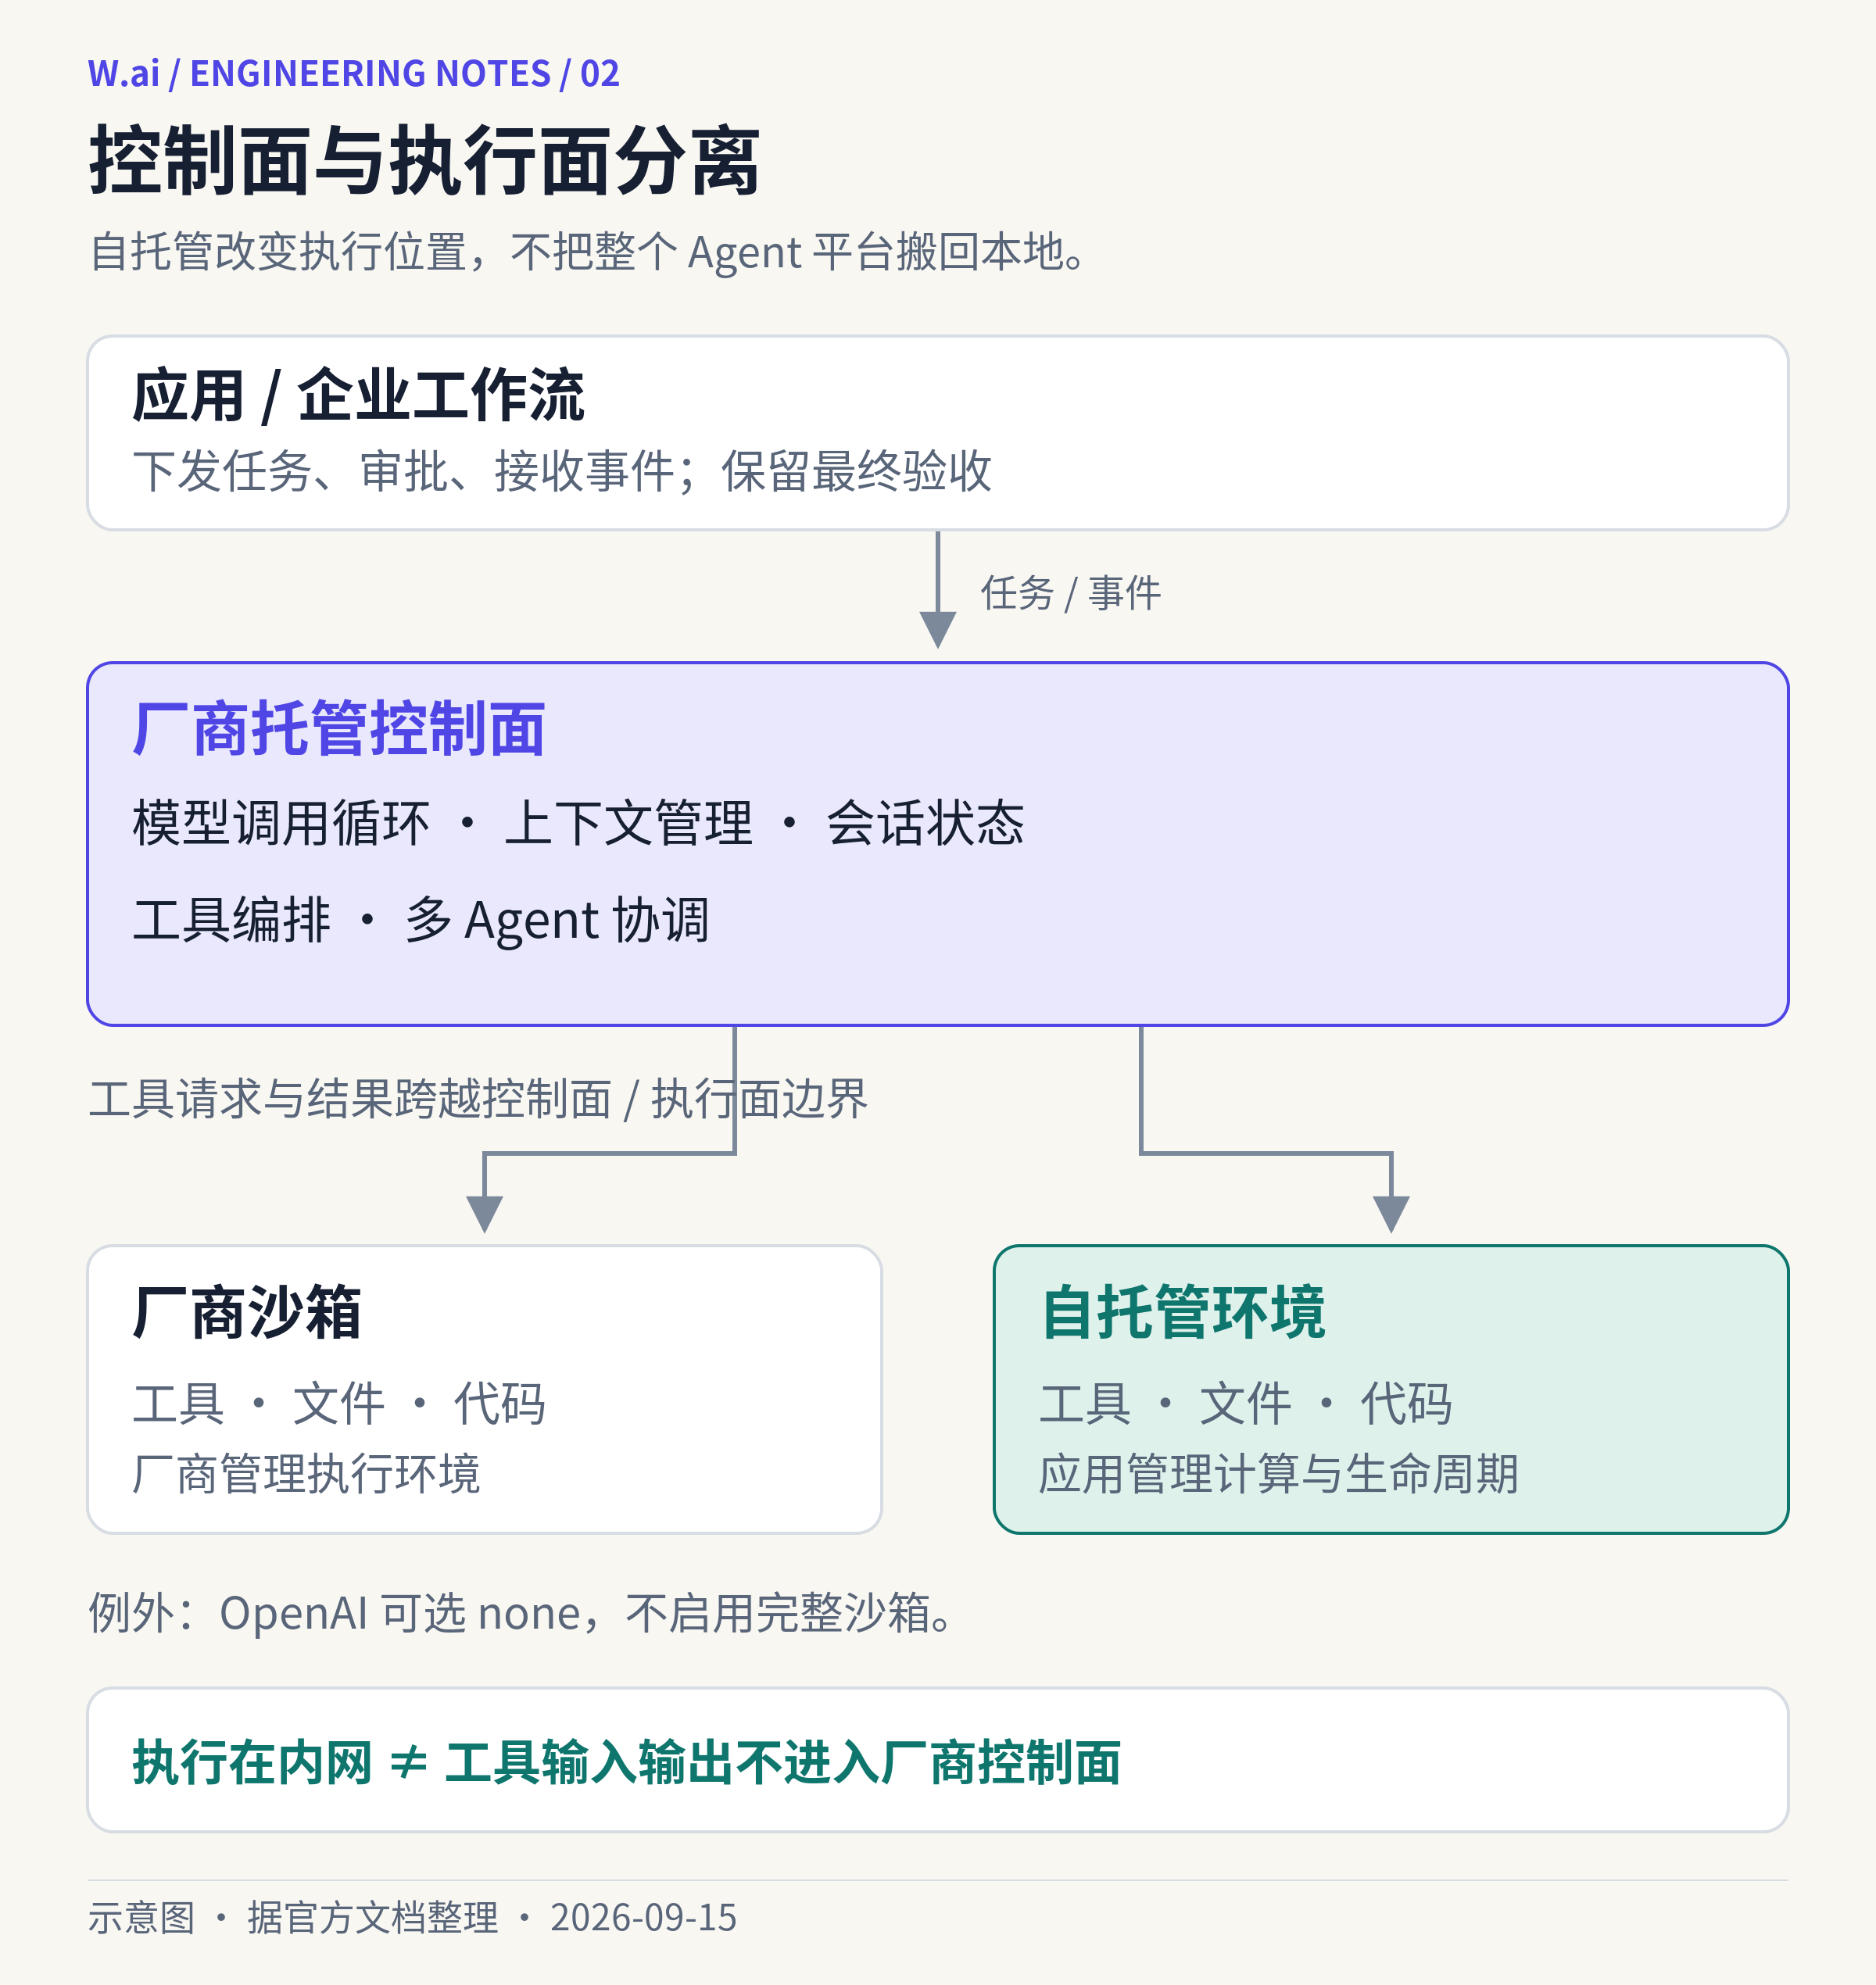
图 2|控制面与执行面边界示意图。根据 OpenAI Architecture与 Claude 自托管沙箱指南整理,2026-09-15。自托管改变工具执行位置,不意味着所有数据留在本地。
执行环境的选择
OpenAI 提供三种环境模式:none 没有自己的 Linux 工作区,但可以调用远程 MCP 和应用 function tools,工具驱动的任务未必需要完整沙箱;openai_hosted 由 OpenAI 准备 Linux 环境,支持预装 packages、初始文件、setup commands、skills 和 plugins;self_hosted 则由应用管理环境与 executor,适用于私网、定制镜像和特殊计算资源。
E2B、Modal、Daytona、Cloudflare 等官方伙伴可以提供不同的 CPU、GPU、VPC 或存储配置,但不能据此认为 OpenAI 默认沙箱具有全部这些规格。[O1][O3][O6]
Claude Managed Agents 提供 cloud 与 self_hosted 两种环境,可使用厂商托管环境,也可在应用自己的基础设施执行;工具包括 Bash、文件操作、Web Search 与 Web Fetch。[A1][A9][A14]
两项服务都支持持续会话、上下文压缩和追加输入以继续或引导工作,Claude 还明确提供中断与临时错误重调度。这些能力减少运行系统的维护负担,并不取消应用对任务成败的责任。OpenAI 虽然使用 Codex harness,官方示例却不限于编码,还覆盖事故调查、Slack 工作助手、数据分析、GitHub 问题调查与文档审阅:复用的是持续运用工具、文件和代码的能力。[O1][O2]
工具调用与多 Agent 协作
工具如何提供给模型、如何进入子 Agent,以及上下文如何分配,是接入时的另一个区别。两家都有原生多 Agent 协作,也都支持 MCP 与自定义业务工具。
| 维度 | OpenAI Agents API | Claude Managed Agents |
|---|---|---|
| 运行系统 | 托管 Codex harness | 托管可配置 harness |
| 内置与业务工具 | 文件与命令、MCP、functions、Web Search | Bash、文件、Web Search/Fetch、MCP、custom tools |
| 工具效率机制 | 自动 compaction、tool search、programmatic tool calling | 上下文压缩及托管工具执行 |
| 原生协作 | 创建、通信、等待、中断子 Agent | coordinator 委派并接续子 Agent thread |
| 并发口径 | 默认 6 个子 Agent,不含协调者,可配置 | 最多 25 个并发 thread,advisor 有例外 |
| 共享边界 | 协调者和子 Agent 共享环境文件系统 | 共享 sandbox、文件系统和 session vault credentials |
OpenAI 的 tool search 按需载入工具定义,避免每轮把全部描述放入上下文;programmatic tool calling 允许用代码并行、串联或过滤工具结果,只把必要信息带回模型,但不是完整 Node/Linux 环境的替代品。自动 compaction 也不是无损的无限记忆:即便记录持久保存,模型当前使用的上下文仍需管理。[O1][O4]
并发和工具继承不能只看表格数字。OpenAI 默认 6 个子 Agent不含协调者,是可配置默认值,不是公布的硬最大并发配额;子 Agent 可以继承 MCP、凭据与 Web Search,访问共享环境的文件与命令工具,当前却不支持 function tools。若业务能力全部封装为应用函数,就需由协调者处理,或设计合适的 MCP/执行端包装,不能假定子 Agent 都能调用。[O4][O9]
Claude coordinator 只能委派一层,roster 最多 20 种 Agent,最多 25 个并发 thread,advisor thread 有例外。各 thread 的上下文、工具配置与历史独立,也可继续追加工作,但共享 sandbox、文件系统与 session 的 Vault 凭据。[A8]
因此,多 Agent 首先是上下文与任务分工,而非租户隔离。增加子 Agent 不会自动获得新安全边界,写相同文件的任务仍需协调;不同用户或租户需要真正分离的 session 和执行环境,而不只是不同的 system prompt。
周期任务的原生配套
运行循环之外,周期任务还需要调度、长期知识、结果检查和预算控制。Claude 已将这些功能做成原生资源;已读取的 OpenAI Agents API 指南与目录中,尚未核到与 Memory stores、Scheduled deployments、session budget 直接对应的接口。OpenAI 可以用自有工具和存储实现跨会话记忆,也可由自己的调度器创建 session,但这与厂商提供原生模块是不同的责任分配。
| 需求 | OpenAI Agents API 的已核证据 | Claude Managed Agents 的已核证据 |
|---|---|---|
| 跨会话记忆 | 未核到直接对应的原生记忆库;可自建 | 版本化 Memory stores |
| 周期执行 | 未核到直接对应的原生定时部署;可外部调度 | POSIX cron + IANA 时区 |
| 结果检查 | 需要自建或接外部验收 | Outcome、rubric 与独立上下文 grader |
| 会话费用上限 | 未核到直接等价接口,不能以普通账户预算代替判断 | 创建 session 时设置 budget |
“未核到接口”不等于厂商没有该能力,也不应把这张表读成“OpenAI 不支持这些工作”。它比较的是当前文档明确提供的模块,不把 Agents SDK 或其他产品的评测功能算到新托管 API 上。OpenAI 的重点是开放 Codex 运行系统、提供可组合执行环境;Claude 则把更多周期性知识工作模块纳入托管平台。这是产品范围差异,不能直接推出任务质量高低。
具体到调度,Claude Scheduled deployments 支持 POSIX 五段 cron 与 IANA 时区,每次触发创建 session,可设置单次运行预算;每个组织最多 1,000 个 scheduled deployments。实际执行允许按运行间隔最高 15% 的抖动,窗口下限 5 秒、上限 9 分钟,适合日报、周报和周期检查,而非秒级交易或精确时刻承诺。Deployment run 成功只表示启动成功,不表示报告写完或消息送达。[A2]
跨会话知识则由 Memory stores 管理:它是带路径的文本集合,可经 API 维护、挂载到 session 供工具读写并跨 session 复用,每次修改产生不可变版本,支持版本审计。每个 session 最多 8 个 store,每个 store 最多 10,000 条 memory,每条最多 100 kB。[A3]
公共规范或资料宜设为只读,用户或项目记忆可按需独立配置读写权限。默认可写也带来跨会话提示注入污染风险:模型写下的内容不因此成为可信事实,可维护的长期知识也不代表模型已自动可靠地学习所有经验。自托管实现还需区分:SDK worker 负责 memory 同步,CLI worker 不挂载 memory;只读可阻止修改上传,但不能保证 Bash 无法改变本地副本,因而不等于各种运行形态都有相同的文件隔离。[A3][A9][A10]
结果检查方面,Outcome 允许应用给出 rubric,由独立上下文的 grader 检查产物,再让执行 Agent 按反馈迭代,例如检查研究报告每条关键结论是否有来源、Excel 是否包含指定 sheet,或结果是否符合 schema。它减少自建评审循环的工程量,却不等于可靠业务验收:独立上下文不是独立事实来源,grader 仍可能漏错。计算、数据准确性、真实发布及合规动作,仍需程序测试、必要的人工审批和外部交付凭证。[A4]
预算控制同样有边界。Claude session budget 按公开 list cost 限制新的模型请求,达到阈值后暂停新模型调用;金额是美分整数字符串,"125" 表示 $1.25,不是 $125。检查发生在新模型请求开始前,已开始的请求仍会完成,多 thread 可能各自超出一次模型请求的费用,因此不是精确到分的硬切断。预算必须在创建 session 时设置:原本没有的不能中途新增,移除后也不能重新添加。[A5]
权限与恢复的边界
授权、凭据与数据合规
托管工具执行,不等于替应用决定业务授权。Claude 的权限策略有 always_allow、always_ask 和 auto;内置 agent toolset 默认允许,MCP 默认询问。auto 是平台自动判断,可能直接放行,并非人工审批。Custom tools 不受这些策略治理,授权与审批仍由应用实现;OpenAI function tools 同样由应用处理。[O9][A6]
高风险动作因此需要应用层准入与审批。网页、工具返回和文档可能含恶意指令,不能获得与用户授权相同的地位。凭据管理也要分清适用范围:OpenAI Vault 用于 OpenAI 服务发起的 MCP 连接,环境端凭据另行管理。[O8]
Claude 除 MCP Vault 外,还在云环境变量中提供 opaque placeholder:真实 secret 不直接放进沙箱,而在出站请求中替换,可限定目标 host 及 header/body 位置。但需要在本地用 secret 计算签名的客户端不能直接使用占位符;换取的新 token 返回沙箱后不保证继续遮蔽;environment_variable Vault 当前也不支持 self-hosted。这不是通用凭据兼容层。[A7]
数据合规须落实到具体产品端点与合同。OpenAI Agents API 当前仅支持美国 data residency、不支持 ZDR,自托管不会改变这项资格;Claude Managed Agents 同样不支持 ZDR,也不适用 HIPAA BAA 覆盖。基础模型 API 的资格不能直接推到托管服务,工具在内网运行也不代表内容不会进入厂商控制面。[O2][A1]
故障恢复与交付
长任务的恢复则要分别看三件事:工作记录是否还在、执行环境能否继续、业务动作是否真正完成。两家都提供 SSE 与 webhooks;OpenAI 可获取 items 和 turns、在平台查看 trace,Claude 提供完整持久事件及 thread、outcome、usage 等事件,但“可恢复会话”不是任何失败都能无损恢复。[O5][O11][A12]
OpenAI 的 SSE 不重放遗漏事件。恢复视图时,先打开新流并缓冲,再获取 session 与已保存 items,按 item ID 重建状态。idle 或关闭 stream 不表示成功,turn.completed 也不保证每个工具成功,仍要检查最终输出与工具结果。[O5]
自托管环境在提交输入时等待连接最多 5 分钟;超时输入不会因稍后连接而自动重放,中途断连不会自动重启被杀命令,也不会自动发出重连请求 webhook。复用 environment ID 不会还原替换机器上的文件,持久卷与快照要自己管理。详细 trace 虽可在平台查看,公共 beta 却不提供外部 trace exporter 或受支持的详细 trace 读取 API;usage 是 best effort,可能为空或后补,不能当最终账单。[O7][O11]
沙箱与记录也有不同寿命。OpenAI-hosted 已连接沙箱会接收 keep-alive,包括两个 turn 之间;只有活动和 keep-alive 都停止 1 小时后才可能删除,不是用户一小时没说话就必删。/workspace/outputs 中在 turn 完成时已发布为不可变产物的内容,可在沙箱过期后下载。Claude 会话历史保留到删除,但 cloud sandbox 自创建日起只保留 30 天,活动不延长窗口,重要产物应进入自己的资料库。两家触发条件不同,简单以“1 小时对 30 天”比较可靠性没有意义。[O6][A12][A13]
至于业务动作,发送邮件、创建工单或修改数据库后,回传结果可能丢失,重新执行可能造成重复。应保存任务 ID、调用 ID、产物 ID 和副作用凭证;不确定是否成功时先查询真实结果,而非直接重试。OpenAI function 文档明确要求持久保存调用结果;同样的工程原则也适用于 Claude custom tools。[O9]
最终交付还须确认产物存在且可读、字段数值正确、外部发布成功、渠道收到消息。运行结束、deployment run 成功或 grader 通过,都不能单独替代这些证据。
费用要按完整任务比较
OpenAI 公告称 Agents API 本身不额外收管理费,但模型、工具与执行环境仍产生费用:主 Agent、子 Agent、重试、压缩等实际模型调用,工具费用,OpenAI 沙箱、自有或第三方计算资源及其他外部服务,都可能进入账单。[O1][O11][O12]
OpenAI-hosted 文档引用标准 container 定价,当前价格表为:
| 内存规格 | 每 container/每 20 分钟 session 公布价格 |
|---|---|
| 1 GiB | $0.03 |
| 4 GiB | $0.12 |
| 16 GiB | $0.48 |
| 64 GiB | $1.92 |
但同页注明,符合条件的 container sessions 按分钟计费,最少 5 分钟。具体 Agents sandbox 的适用资格尚未核清,也没有证据证明每个规格都能在该 API 中选择,不能据此推出任意任务的确定小时价。缓存写入可能另外收费,而 usage 没有独立计数,仍需与最终账单核对。[O6][O11][O12]
Claude 当前计费为模型 tokens + $0.08/running session-hour + 搜索等相关费用。运行费精确到毫秒,仅对 running 状态收取;idle、rescheduling、terminated 不收这一项,也不额外叠加 code-execution container-hour。多个 thread 重叠运行时间在 session runtime 中只计一次,各 thread 的模型 tokens 则分别计费。[A11][A5]
Web Search 为 $10/1,000 次,缓存遵循所选模型政策,托管 session 不适用 Messages Batch 折扣。运行 4 小时的 runtime 项为 $0.32,不代表整份研究报告只花 $0.32。[A11][A5]
公平指标应是通过同一验收标准的完整任务总成本,结合成功率、人工介入时间与 P95 交付时延。更合适的模型可能减少轮次,更完整的平台可能节约开发运维,更多子 Agent 则可能增加 tokens 与合并成本。这些都要同任务实测;不同模型单价不能自动换算成平台性价比,“API 免费”或某项小时价也不能给出答案。
如何选择与接入
希望复用 Codex 运行方式、处理代码文件、密集调用工具并组合执行环境,可以优先评估 OpenAI Agents API;需要定时、记忆、评审与预算共同支撑周期性研究、运营和检查,可以优先评估 Claude Managed Agents。这是按产品范围安排试用顺序,而非模型质量、稳定性或成本排名;本文未验证具体账户的地区资格、配额、性能或 SLA。
| 需求 | 建议的评估起点 | 必须保留的条件 |
|---|---|---|
| 代码、文件、工具密集任务 | OpenAI Agents API | 实测 harness、沙箱、tool search 与 PTC;不预设质量领先 |
| 周报、运营研究、周期检查 | Claude Managed Agents | 原生配套较完整,但业务验收与审批仍由应用负责 |
| 多模型、复杂权限、已有控制系统 | 将两家作为可替换执行端 | 用户状态、资产和交付不全部锁在厂商 session |
| 简短一次性调用、步骤完全固定 | 优先考虑基础模型 API | 未必需要完整托管 Agent 状态模型 |
| 必须 ZDR 或严格数据本地化 | 不直接选用本次两项托管服务 | 另评合规端点、合同、自管 harness 与可用模型 |
对已有 OpenClaw 或自有多 Agent 系统,更稳妥的方向是保留任务入口与业务控制,把两项服务作为执行适配器。自己的系统继续管理任务账本、租户权限、审批、预算和最终期限,并统一验收、投递;模型 provider 兼容不等于支持托管 session、事件与制品协议,仍需单独适配。
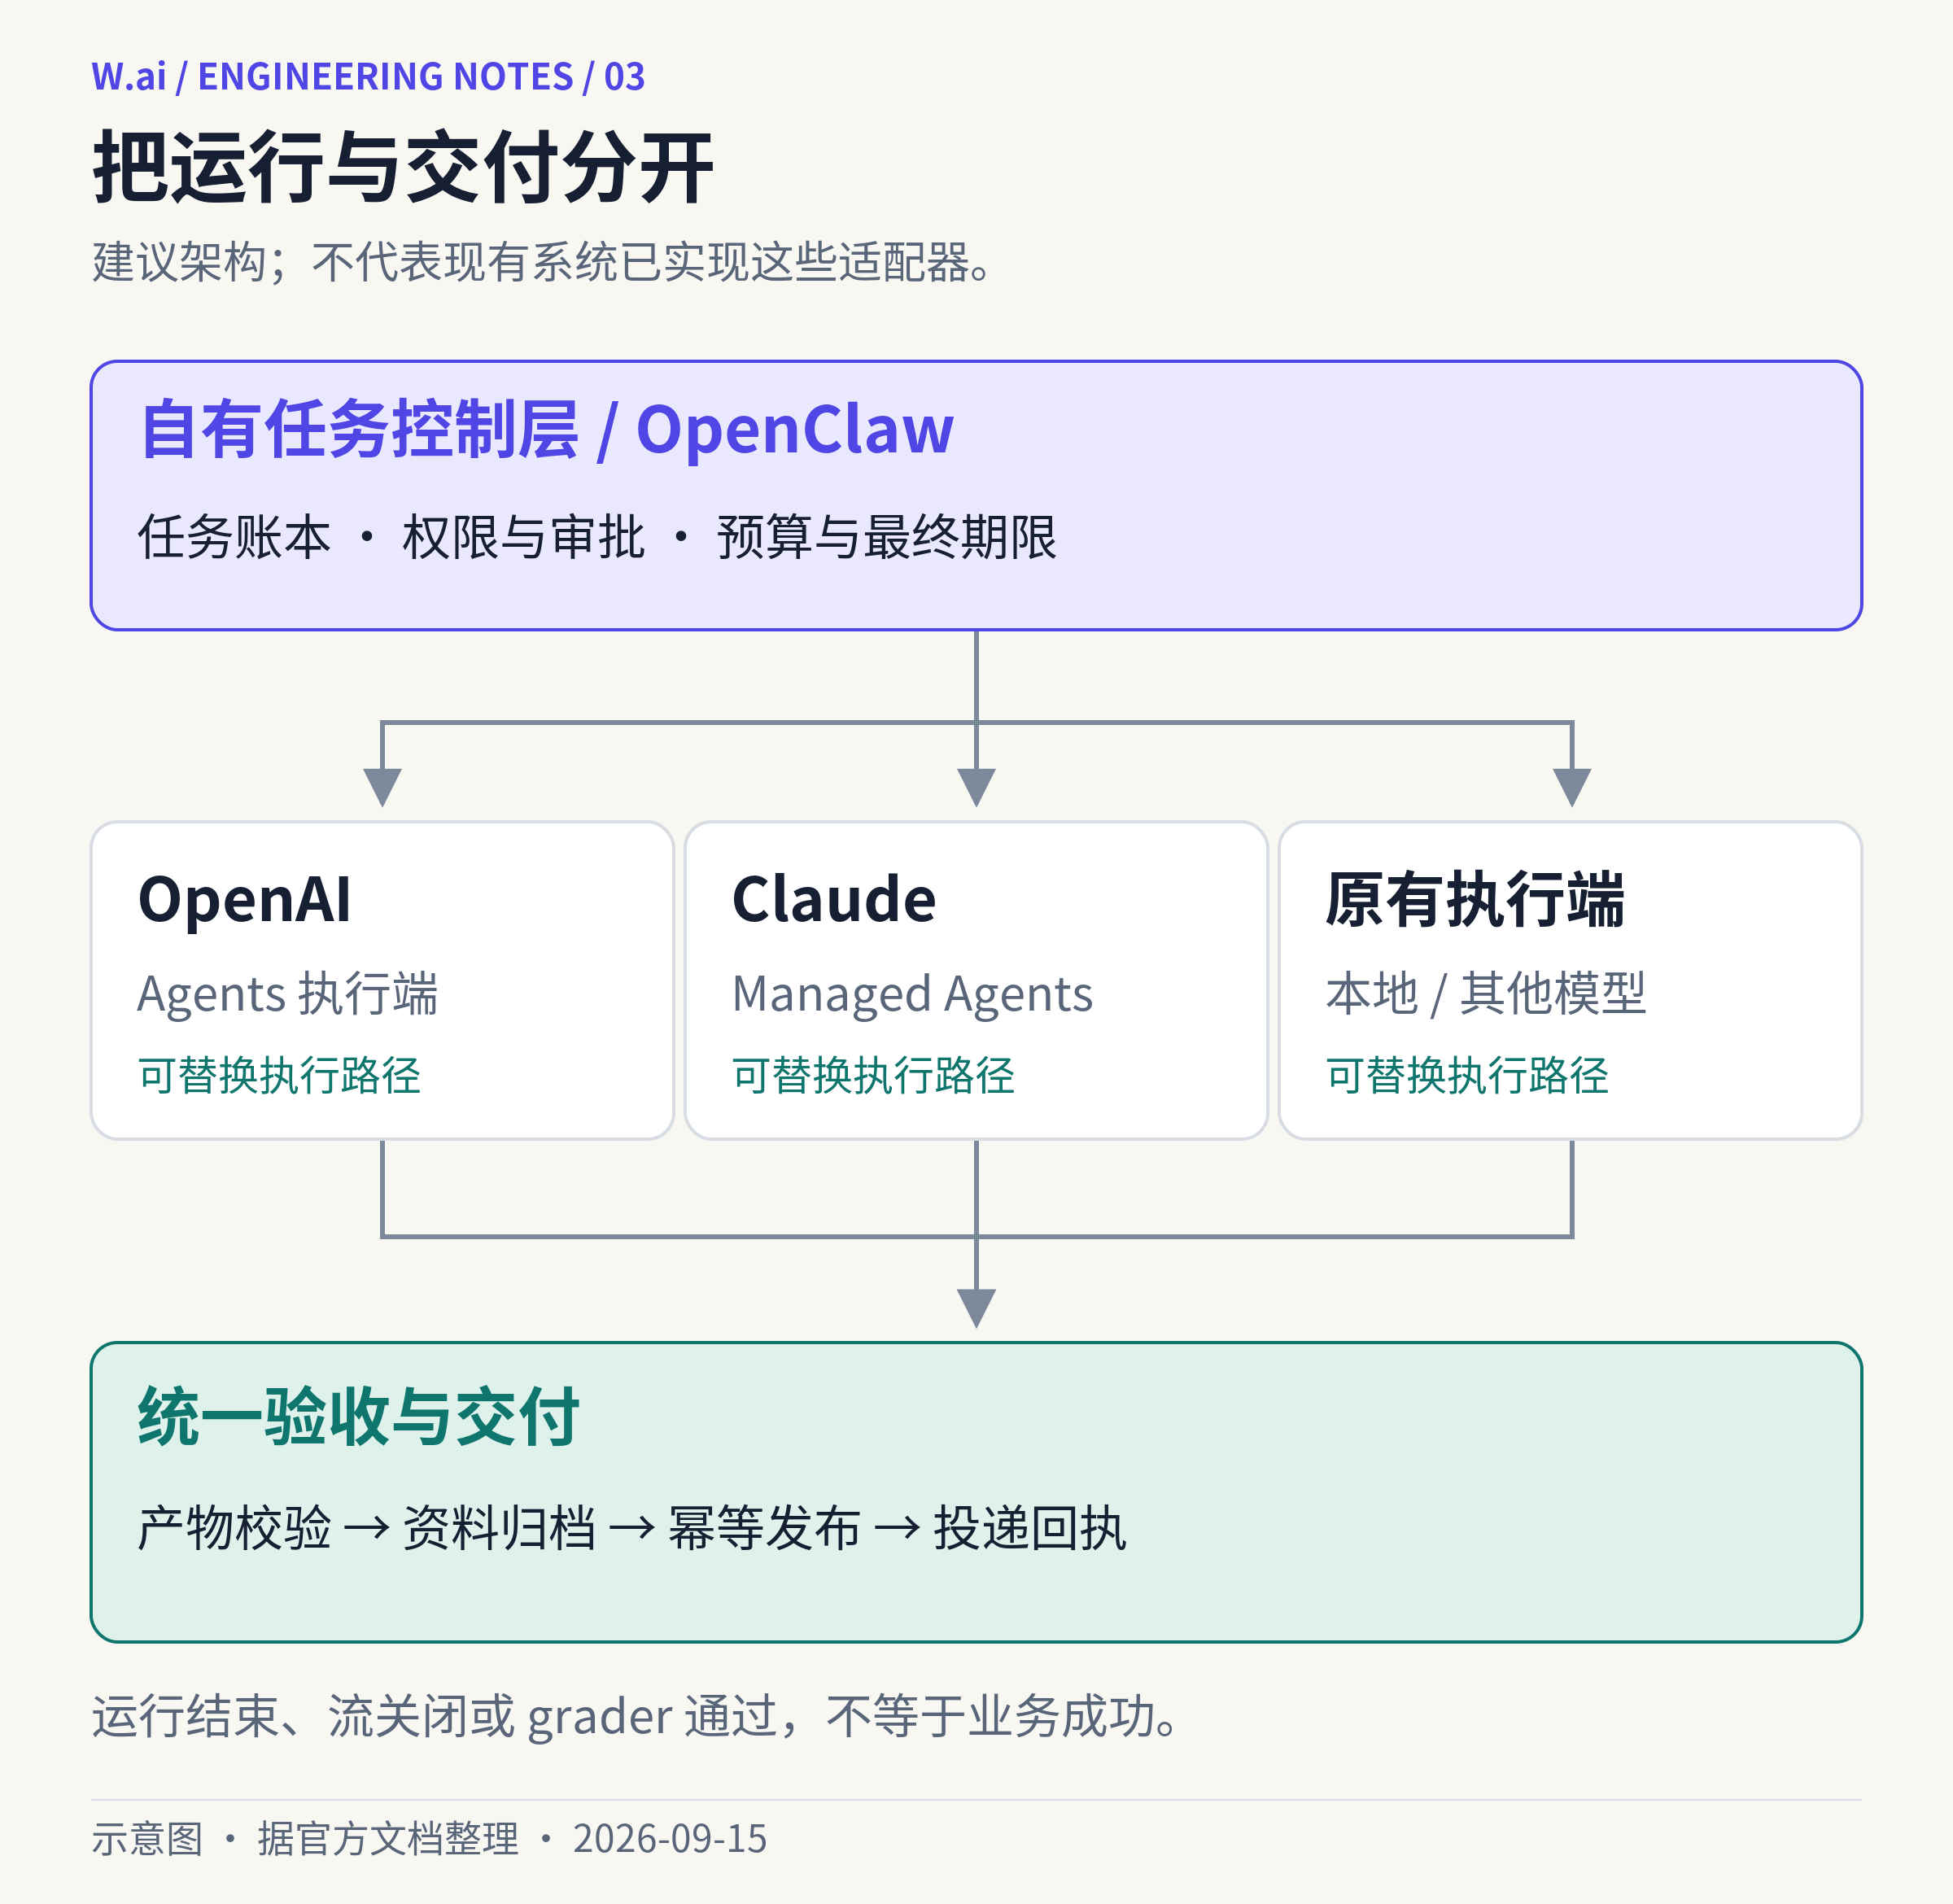
图 3|可替换执行端与统一交付层示意图。依据本文研究结论绘制;运行责任参考 OpenAI Architecture与 Claude Managed Agents 概览,2026-09-15。此图是接入建议,不代表 OpenClaw 已开箱实现这些适配器。
接入前可用公开或合成数据做小型 POC,只有验收通过且总成本/维护负担确实改善,才替换执行器,并保留回退路线。本文未创建或运行 POC,也未复现示例;小样本只能发现集成问题,不能证明总体稳定性。并发配额、账户资格、实际计费粒度、最长运行时间与 SLA,仍需在生产前核实。详细测试方案另列于下方补充区。
从当前产品范围看,通用循环、上下文压缩、沙箱和基础委派正在成为标准服务,仅靠封装 prompt、调用几个工具的产品,差异会缩小。更持久的应用价值在行业数据、工作流权限、可信结果验收、业务系统集成、失败恢复、审计和跨供应商交付;这是根据产品责任边界作出的研究判断,不是厂商未来市场份额预测。选择哪一家,最终要回答的是:在自己的权限、成本与交付标准下,哪种运行方式更合适。
补充:小型 POC 测试方案
固定三类任务:带来源的研究摘要、文档或表格结构化产物、带人工审批的模拟外部动作。使用公开或合成数据,关闭真实发布;共同验收来源真实性、字段与数值正确性、文件可打开、失败有记录,以及审批前没有副作用。
故障测试覆盖客户端 SSE 断连、自托管 executor 断连、工具超时、动作已执行但回执丢失、等待输入时暂停,以及预算或期限到达。记录验收成功率、全任务 tokens/工具/沙箱账单、总耗时与 P95、人工介入次数、重复副作用次数和恢复后的文件完整性。
参考来源(27 项官方资料)
OpenAI
- O1 Introducing the Agents API:公告、public beta、Codex harness、生态与管理费口径。
- O2 Agents API overview:产品原语、定价引用、US residency与ZDR。
- O3 Architecture:none/hosted/self-hosted与责任划分。
- O4 Multi-agent:默认并发、共享环境、function工具限制。
- O5 Events and items:流恢复与完成语义。
- O6 OpenAI-hosted sandboxes:环境、网络、产物和到期规则。
- O7 Sandbox lifecycle:连接5分钟、断连、输入与文件恢复限制。
- O8 Vaults:service-origin MCP秘密管理。
- O9 Functions:应用执行、恢复、幂等结果记录。
- O10 Sandbox security:隔离、出口、应用key与environment key分离。
- O11 Observability and usage:trace边界、usage非最终账单、缓存写费。
- O12 Pricing:tokens、tools、container价格及分钟计费注记。
- O13 Configuration:可复用配置、session覆盖与环境设置。
Anthropic
- A1 Managed Agents overview:beta、访问、架构、ZDR/BAA。
- A2 Scheduled deployments:cron、timezone、jitter、run记录与上限。
- A3 Memory:版本化记忆、容量、访问控制与同步。
- A4 Define outcomes:rubric、独立上下文grader与迭代。
- A5 Budgets:list cost、金额单位、阈值与超额边界。
- A6 Permission policies:工具默认权限、auto与custom边界。
- A7 Vaults:MCP、出站secret替换、host/header/body与兼容性。
- A8 Multiagent orchestration:共享环境、thread/roster上限与版本固定。
- A9 Self-hosted sandboxes:worker、自托管内网与memory同步。
- A10 Self-hosted security:责任分界与本地只读副本限制。
- A11 Pricing:$0.08/running session-hour与token/搜索计费。
- A12 Events and streaming:事件恢复、预览、30天sandbox窗口与usage。
- A13 Session operations:idle/terminated与删除语义。
- A14 Cloud sandbox reference:预装工具与规格。